# AI 에이전트가 우리 사이트에 온다: Grok Bot 사례로 본 마케터의 트래픽·데이터 대응법
- URL: https://troe.kr/insights/ai-agent-traffic-marketing/
- 작성: 박충효 (TROE)
- 게시: 2026-11-18
- 분류: AI 마케팅
> **한 줄 정의** AI 에이전트 트래픽 대응은 학습·검색 크롤러뿐 아니라 사용자를 대신해 로그인하고 폼을 작성하는 AI 에이전트의 방문을 구분해, 콘텐츠 영역은 AI 검색 노출을 위해 열어 두고 폼·쿠폰·결제처럼 데이터와 돈이 걸린 영역에는 확인 단계를 두며, GA4와 광고 전환 데이터에 섞인 에이전트 신호를 점검하는 마케팅 운영 방식입니다.
## 핵심 요약
- xAI의 AI 에이전트 Grok Bot은 클라우드 브라우저에서 사용자 대신 로그인하고 폼을 작성합니다. Fingerprint에 따르면 2026년 10월 9일 무렵부터 자기 신원을 밝히는 서명을 멈춰, 웹사이트에서는 사람의 브라우저 세션처럼 보입니다.
- Thales의 2026 Bad Bot Report에서 2025년 웹 트래픽의 53%가 봇이었고 사람은 47%였습니다. 보고서는 AI 에이전트를 기존의 좋은 봇·나쁜 봇과 다른 세 번째 트래픽 유형으로 봅니다.
- 우리 사이트에 오는 AI는 학습 크롤러, 검색 크롤러, 사용자 요청 수집, 작업형 에이전트 네 가지로 나뉩니다. robots.txt로 관리되는 것은 앞의 일부이고, 사용자 요청과 작업형 에이전트는 robots.txt만으로 관리되지 않을 수 있습니다.
- GA4는 알려진 봇만 자동으로 제외합니다. 사람 브라우저처럼 움직이는 에이전트는 세션·폼 제출·전환으로 집계될 수 있고, 그 전환이 광고 플랫폼으로 넘어가면 입찰 알고리즘이 엉뚱한 신호를 학습할 수 있습니다.
- 대응의 기준은 차단이 아니라 영역별 정책입니다. 콘텐츠는 AI 검색 노출을 위해 열어 두고, 문의·가입·쿠폰은 확인 단계를 두고, 결제·계정 변경은 사람 확인을 거치게 합니다.
지난달 우리 사이트에 들어온 방문자 중 사람은 몇 명이었을까요? 이 질문에 자신 있게 답하기가 점점 어려워지고 있습니다. 보안 기업 Fingerprint는 11월 2일 글에서 xAI의 AI 에이전트 Grok Bot이 10월 초부터 자기 이름을 밝히지 않고 웹사이트를 방문한다고 알렸습니다. 이 글은 그 사례를 출발점으로, AI 에이전트 트래픽이 GA4와 광고 전환, 리드 데이터에 어떤 영향을 주는지와 마케터가 무엇을 열고 무엇을 확인해야 하는지를 정리한 것입니다.
ACT 1 · 문제 — 사람처럼 보이는 방문자가 늘었다
## Grok Bot은 무엇이고, 왜 알아보기 어려운가?
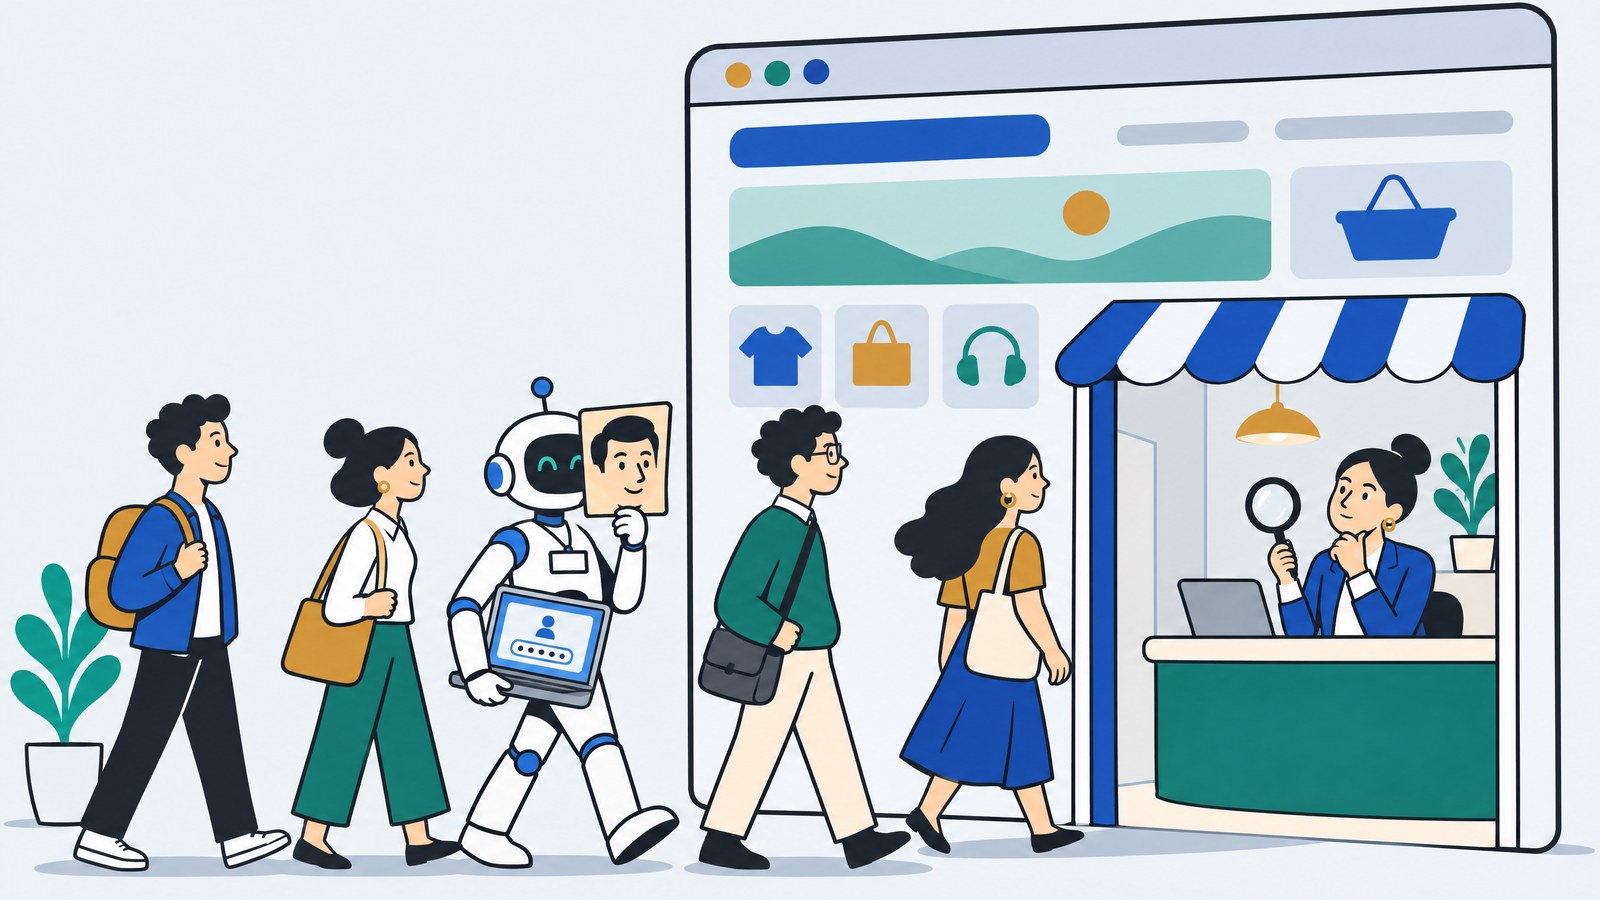
사용자 대신 로그인하고 폼을 채우는 AI 에이전트인데, 이제 자기 신원을 밝히지 않기 때문입니다. Fingerprint에 따르면 Grok Bot은 사용자가 이름을 붙여 만든 봇에 일을 맡기는 방식으로 작동합니다. 각 봇은 계속 켜져 있는 클라우드 브라우저에서 돌아가기 때문에 사용자가 오프라인이어도 일을 이어 갑니다. 실제 계정 정보로 로그인하고 사람처럼 폼을 작성하므로, 웹사이트 입장에서는 사람이 브라우저를 쓰는 세션과 비슷하게 보입니다.
사람 방문자 사이에, 이름표를 비운 AI 에이전트가 섞여 들어온다
원문은 Grok Bot이 2026년 10월 9일 무렵까지는 Web Bot Auth라는 서명으로 자신을 밝혔지만, 그 뒤로 서명을 멈췄다고 설명합니다. 그리고 탐지가 어려운 이유를 세 가지로 듭니다. 확인할 수 있는 신원이 없고, 화면을 띄운 실제 브라우저를 쓰기 때문에 자동화 흔적이 없으며, 사용자의 인터넷 연결을 거쳐 들어올 수 있어 데이터센터 IP 같은 단서도 없다는 것입니다. 원문의 결론은 분명합니다. 스스로 밝힌 신원만으로는 더 이상 믿을 만한 신호가 아니라는 것입니다.
Grok Bot 하나의 이야기가 아닙니다. 원문은 같은 방식으로 감지하는 AI 에이전트로 Meta, OpenAI, Google, Anthropic, Perplexity의 에이전트를 함께 언급합니다. 사용자를 대신해 웹에서 일하는 AI는 이미 주요 AI 회사 대부분이 내놓은 제품입니다.
## AI 에이전트 트래픽은 얼마나 늘었는가?
웹 트래픽의 절반 이상이 이미 사람이 아닙니다. Thales의 2026 Bad Bot Report에 따르면 2025년 웹 트래픽 중 봇이 53%로 전년 51%에서 늘었고, 사람은 47%였습니다. 악성 봇만 40%였습니다. 보고서는 AI 에이전트를 기존의 좋은 봇·나쁜 봇과 구분되는 세 번째 트래픽 유형으로 분류하고, 자동화 트래픽이 늘수록 참여율·전환율·수요 신호 같은 지표를 해석하기 어려워진다고 지적합니다. 트래픽이 늘었다고 해서 고객 관심이 늘었다는 뜻이 아닐 수 있다는 것입니다.
에이전트가 향하는 곳도 마케터에게 중요합니다. 봇 보안 기업 DataDome의 2026년 보고서를 인용한 보도에 따르면, 2026년 상반기 AI 에이전트가 로그인·폼·장바구니·결제·계정 생성 페이지에 보낸 요청은 6억 건이 넘었고, 그중 로그인 페이지가 절반 이상이었습니다. 문의 폼, 회원가입, 쿠폰 발급처럼 마케팅 전환이 일어나는 바로 그 지점입니다.
ACT 2 · 구분 — 어떤 AI가, 무엇을 하러 오는가
## 우리 사이트에 오는 AI는 어떤 종류가 있는가?
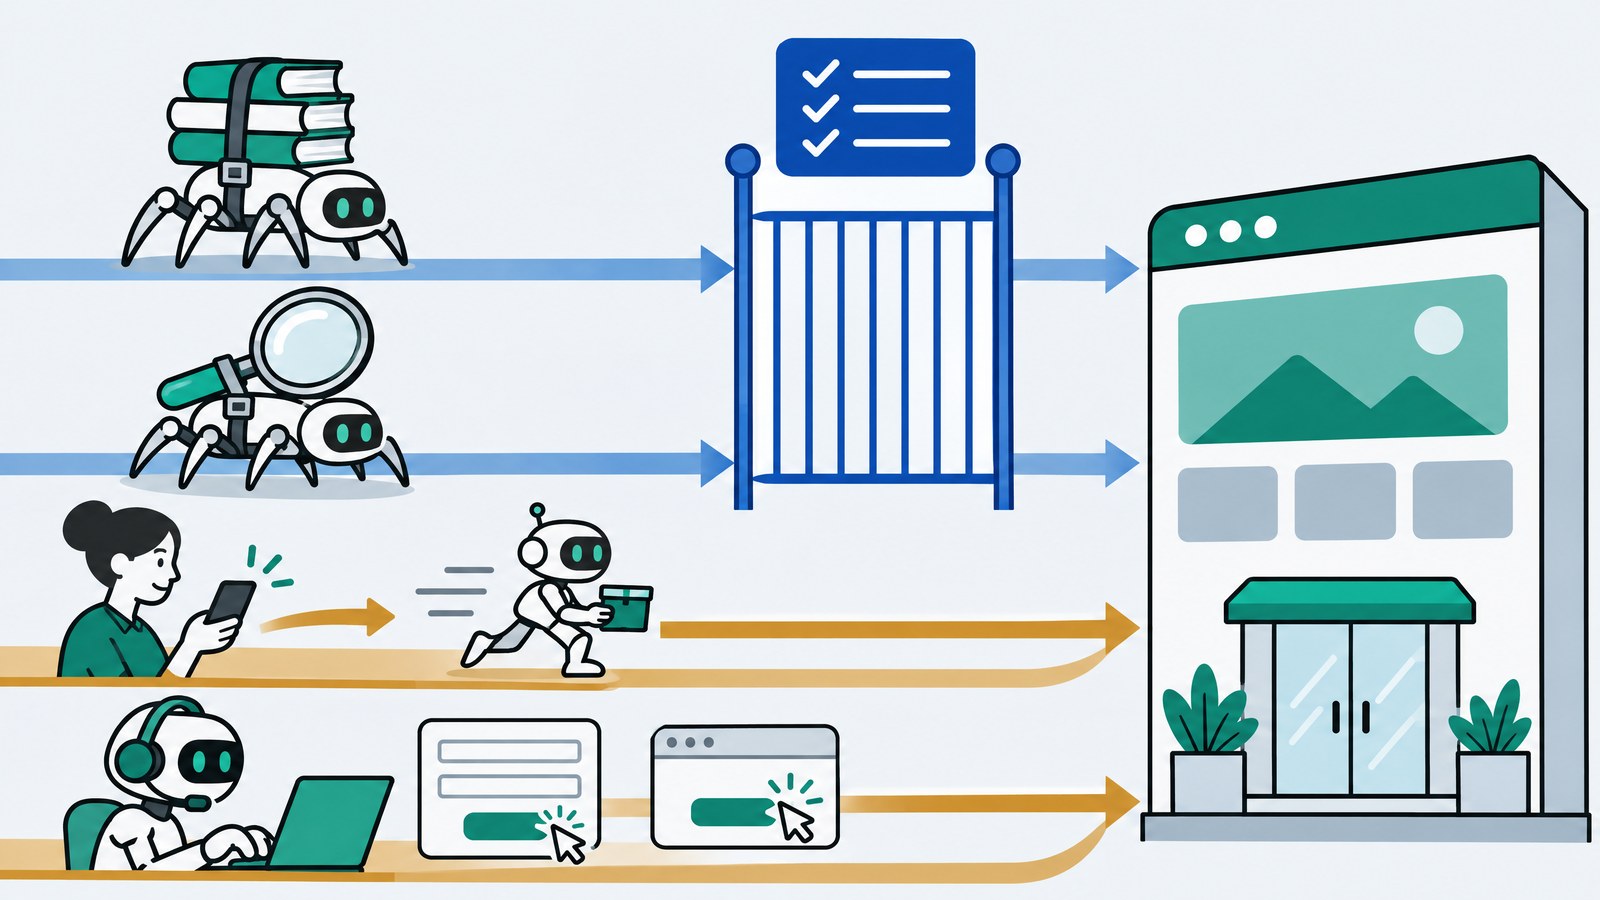
학습 크롤러, 검색 크롤러, 사용자 요청 수집, 작업형 에이전트 네 가지로 나눠 보면 대응이 쉬워집니다. 앞의 둘은 이름을 밝히고 robots.txt 규칙을 따르지만, 뒤로 갈수록 사람의 요청과 행동에 가까워져 robots.txt만으로 관리하기 어렵습니다.
robots.txt 관문은 학습·검색 크롤러에만 서 있다. 사용자 요청과 작업형 에이전트는 그 옆으로 들어온다
| 유형 | 예시 | 하는 일 | robots.txt | 마케팅 관점 |
|---|---|---|---|---|
| 학습 크롤러 | GPTBot, ClaudeBot | AI 모델 학습용 데이터 수집 | 따름 | 막으면 학습 데이터에서 빠짐. 노출과는 별개 |
| 검색 크롤러 | OAI-SearchBot, Claude-SearchBot | AI 검색·답변에 쓸 색인 | 따름 | 막으면 AI 답변 인용 기회가 줄 수 있음 |
| 사용자 요청 수집 | ChatGPT-User, Claude-User | 사용자가 물어본 페이지를 그때 가져옴 | OpenAI는 적용되지 않을 수 있다고 안내 | 실제 사람의 관심이 뒤에 있는 방문 |
| 작업형 에이전트 | Grok Bot 같은 브라우저 에이전트 | 로그인, 폼 작성, 구매 등 작업 수행 | 사실상 기대하기 어려움 | 세션·전환·리드 데이터에 섞일 수 있음 |
OpenAI는 학습용 GPTBot, 검색용 OAI-SearchBot, 사용자 요청용 ChatGPT-User를 구분해 공개하고, 사용자가 시작한 요청에는 robots.txt 규칙이 적용되지 않을 수 있다고 안내합니다. Anthropic도 ClaudeBot, Claude-SearchBot, Claude-User를 나누고, 검색용이나 사용자 요청용을 막으면 사용자 검색 결과에서의 노출이 줄 수 있다고 설명합니다.
여기서 마케터가 가장 먼저 기억할 점은 하나입니다. 콘텐츠로 리드를 만드는 기업이라면, AI 크롤러를 일괄 차단하는 것은 AI 검색 시대의 노출을 스스로 줄이는 선택일 수 있습니다. 반대로 작업형 에이전트는 차단 목록이 아니라 데이터 품질의 문제로 다뤄야 합니다. AI 검색 노출 전략은 [SEO·AEO·GEO 실무 가이드](https://troe.kr/insights/seo-aeo-geo-guide/)에 따로 정리했습니다.
## AI 에이전트 트래픽은 마케팅 데이터를 어떻게 오염시키는가?
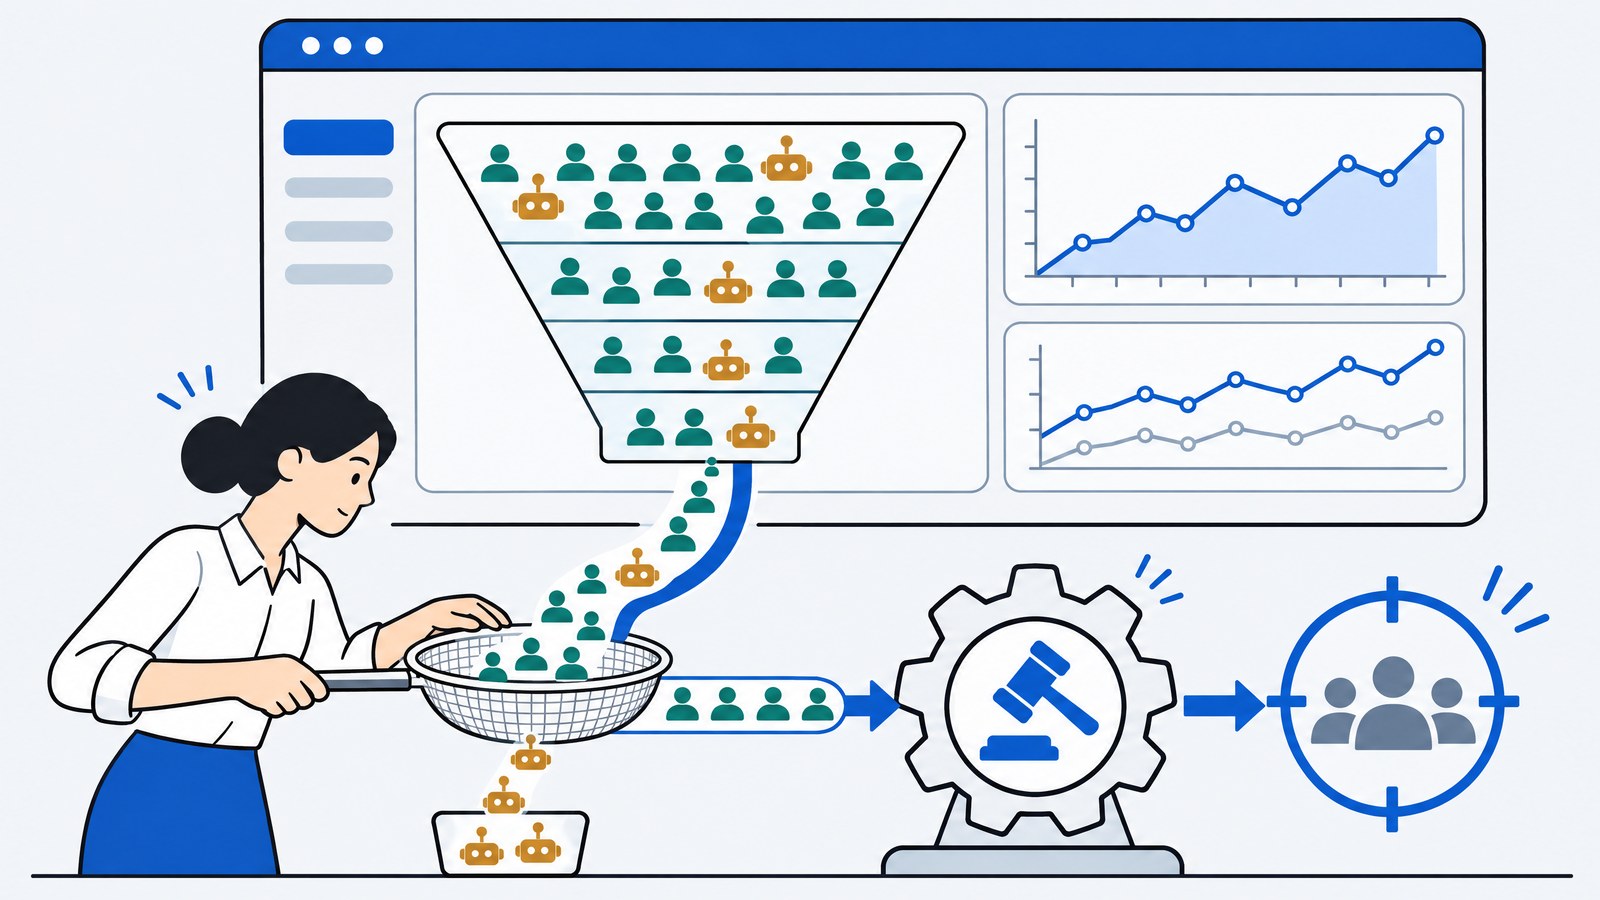
사람처럼 보이는 세션이 GA4의 방문·참여·전환으로 집계되고, 그 전환이 광고 플랫폼의 학습 신호로 넘어갈 수 있기 때문입니다. GA4는 알려진 봇과 스파이더를 자동으로 제외하지만, 이 기능은 끌 수도 없고 얼마나 제외됐는지도 보여 주지 않습니다. 알려진 목록에 없거나 사람 브라우저처럼 움직이는 에이전트는 이 필터를 그대로 지나갈 수 있습니다.
에이전트 세션이 전환으로 집계되면, 광고 입찰 알고리즘은 그 신호를 학습한다
| 영향을 받는 곳 | 이렇게 나타날 수 있다 | 먼저 볼 것 |
|---|---|---|
| GA4 방문·참여 지표 | 유입은 늘었는데 참여 패턴이 비정상적으로 균일하거나 짧음 | 서버·CDN 로그의 AI 봇 비중과 GA4 세션 추이 비교 |
| 문의·가입 폼 | 형식은 완벽한데 후속 연락에 반응이 없는 리드 증가 | 리드별 후속 응답률, 영업 단계 전환율 |
| 광고 전환 신호 | 전환은 늘었는데 실제 매출·계약은 그대로 | 플랫폼 전환과 CRM 확정 리드·매출의 차이 |
| 쿠폰·이벤트 | 신규 가입 혜택의 반복 발급, 응모 수 급증 | 계정·결제 수단당 발급 수, 응모 패턴 |
| A/B 테스트 | 변형 간 차이가 에이전트 세션 비중에 따라 흔들림 | 테스트 기간의 봇 의심 세션 비중 |
가장 비싼 오염은 광고 쪽입니다. Meta나 Google 광고는 우리가 보내는 전환 신호를 학습해 비슷한 사용자를 찾습니다. 에이전트가 만든 폼 제출이 전환으로 계속 들어가면, 알고리즘은 사람이 아닌 신호에 맞춰 입찰을 최적화할 수 있습니다. 그래서 광고 전환은 가능하면 단순 폼 제출보다 영업이 확인한 리드나 실제 결제처럼 사람이 확인한 단계에 가깝게 잡는 것이 안전합니다. AI가 만든 숫자를 확인하는 방법은 [AI가 만든 마케팅 리포트, 출처부터 물어보세요](https://troe.kr/insights/ai-marketing-report-source-check/)에서 이어서 볼 수 있습니다.
TROE가 함께하는 지점 · 측정 체계와 전환 신호 점검
GA4·광고 전환 설정부터 에이전트 신호가 섞이는 지점을 같이 찾습니다
TROE는 마케팅 조직의 목표·KPI와 이벤트 택소노미, 측정 거버넌스를 자문해 왔습니다. GA4 주요 이벤트와 광고 전환 설정, CRM 리드 데이터를 함께 보고, AI 검색 노출과 데이터 품질을 모두 고려한 크롤러 정책과 확인 단계를 설계합니다.
## AI 에이전트는 막아야 하는가, 맞이해야 하는가?
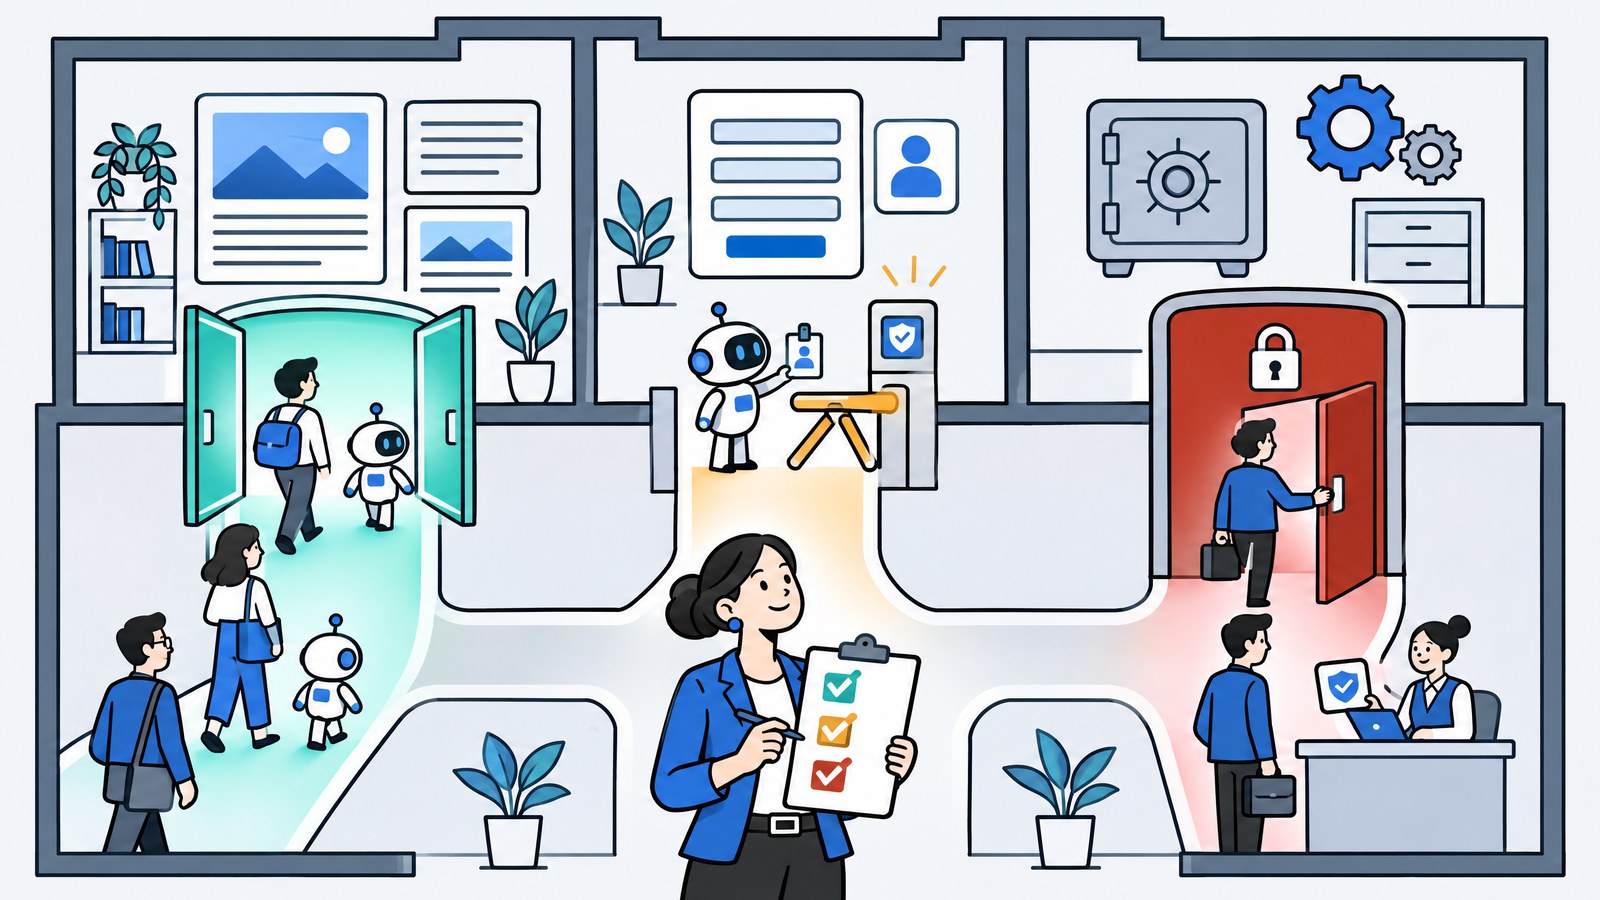
둘 다 아닙니다. 사이트의 영역마다 다른 정책을 둡니다. 원문도 Fingerprint가 붙이는 '나쁜 봇' 표시는 신원을 밝히지 않는다는 뜻이지 반드시 악의적이라는 뜻은 아니라고 밝히고, 허용·민감한 흐름에 마찰 추가·차단 중 하나를 고르라고 권합니다. 마케팅 사이트로 옮기면 기준은 '그 영역에서 무엇이 잘못되면 얼마나 비싼가'입니다.
콘텐츠는 열고, 폼과 혜택에는 확인 단계를, 결제와 계정 변경에는 사람 확인을
| 영역 | 기본 정책 | 이유 | 이렇게 한다 |
|---|---|---|---|
| 콘텐츠·블로그·서비스 소개 | 허용 | AI 검색과 답변에 인용될 기회 | 검색·사용자 요청 크롤러 허용, 구조화된 요약·FAQ·llms.txt 제공 |
| 문의·자료 요청·뉴스레터 | 마찰 | 리드 품질과 전환 신호 보호 | 이메일 확인, 간단한 질문 한 개, 이상 패턴 감지 |
| 회원가입·쿠폰·이벤트 | 마찰 강화 | 혜택 반복 수령과 비용 | 계정·결제 수단당 한도, 지급 전 확인 |
| 결제·계정 변경·관리 | 사람 확인 | 되돌리기 어렵고 돈이 걸림 | 추가 인증, 변경 알림, 이상 거래 검토 |
에이전트를 고객으로 맞이하는 관점도 필요합니다. 사람들이 AI 에이전트에게 업체 비교와 견적 요청을 맡기는 일이 늘수록, 에이전트가 읽기 쉬운 구조(명확한 서비스 설명, 가격·조건, FAQ, 구조화 데이터)를 갖춘 사이트가 먼저 후보에 오릅니다. 막는 기술보다 '어디까지 열고 어디서 확인할지'를 정하는 정책이 마케터의 몫입니다.
ACT 4 · 실행 — 이번 달 점검
## 마케터는 무엇부터 점검하는가?
크롤러 정책, 로그와 GA4의 차이, 리드 품질, 광고 전환 정의 네 가지를 이번 달에 한 번 점검하고, 그 뒤로는 월간 루틴으로 돌립니다.
robots.txt에서 학습 크롤러와 검색·사용자 요청 크롤러를 구분해 정책을 정했는가 (일괄 차단이나 무조건 허용이 아니라 선택)
서버·CDN 로그의 AI 봇 요청 비중을 확인하고, GA4 세션 추이와 비교했는가
문의 리드의 후속 응답률과 영업 단계 전환율을 리드 유입 경로별로 보고 있는가
광고 전환을 단순 폼 제출이 아니라 사람이 확인한 단계(유효 리드, 결제)에 가깝게 정의했는가
쿠폰·이벤트·가입 혜택에 계정당 한도와 지급 전 확인 단계가 있는가
결제·계정 변경 같은 되돌리기 어려운 흐름에 추가 인증과 알림이 있는가
아래 두 가지는 바로 가져다 쓸 수 있습니다. 첫 번째는 robots.txt 정책 예시입니다. 콘텐츠로 리드를 만드는 B2B 기업에서 흔히 쓰는 'AI 검색 노출은 유지하고 학습만 선택'하는 구성입니다. 우리 회사 정책에 맞게 고른 뒤 개발 담당자와 함께 반영하세요. 크롤러 이름은 각 사 공식 문서 기준이며 바뀔 수 있으니 반영 전에 다시 확인하세요. 두 번째는 월간 점검을 AI에게 맡길 때 쓰는 지시문입니다.
```text
#[검색·답변 인용용] 노출을 원하면 허용
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
#[사용자 요청 수집] 사용자가 우리 페이지를 물어볼 때 가져가는 방문
User-agent: ChatGPT-User
Allow: /
User-agent: Claude-User
Allow: /
#[모델 학습용] 학습 제외를 원하면 아래 두 곳의 Allow: / 를 Disallow: / 로 변경
User-agent: GPTBot
Allow: /
User-agent: ClaudeBot
Allow: /
#[공통] 관리·결제 경로는 모든 봇에 비공개
User-agent: *
Disallow: /admin/
Disallow: /checkout/
Sitemap: https://우리도메인/sitemap.xml
```
```text
[월간 AI 에이전트 트래픽 점검 · AI에게 맡길 때]
아래 데이터를 비교해 표로 정리해 줘. 수치마다 파일·시트·셀 출처를 붙여 줘.
입력:
- GA4: 지난 3개월 월별 세션, 참여 세션, 주요 이벤트, 문의 폼 제출
- 서버·CDN 로그: 같은 기간 AI 봇(GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot,
Claude-SearchBot, Claude-User 등) 요청 수
- CRM: 같은 기간 문의 리드 수, 후속 응답 리드 수, 유효 리드·계약 수
- 광고 플랫폼: 같은 기간 전환 수
정리할 것:
1. GA4 문의 제출 대비 CRM 유효 리드 비율의 월별 변화
2. 광고 플랫폼 전환과 CRM 확정 리드의 차이
3. AI 봇 요청 수 변화와 GA4 세션 변화가 같은 방향인지
4. 이상하다고 판단한 항목 3개와 그 근거, 사람이 직접 확인할 원본 목록
※ 원인을 단정하지 말고, 확인이 필요한 가설로만 적어 줘.
```
01AI를 네 종류로 나눈다
02콘텐츠는 열고, 폼은 확인
03전환은 사람이 확인한 단계로
## TROE는 AI 에이전트 시대의 마케팅 데이터를 어떻게 함께 지키는가?
AI 검색에 잘 보이는 것과 마케팅 데이터를 깨끗하게 유지하는 것은 함께 설계해야 하는 일입니다. TROE는 AI 검색 노출(GAEO)과 측정 체계 자문을 함께 다루고, 크롤러 정책부터 전환 정의, 월간 점검 루틴까지 담당자가 직접 운영할 수 있게 넘깁니다.
WHY TROE · AX WORKS
AI 검색에는 잘 보이고, 마케팅 데이터는 사람의 신호로 지킵니다
마케팅 자문
2004년부터 디지털 전략·성장 자문. 목표·KPI 설계, 이벤트 택소노미와 측정 거버넌스, 광고 전환 설정 점검
AX 프로젝트
리포트·점검 업무에 사람 승인 지점(H)과 개선 구간(P)을 표시하고, 월간 트래픽·리드 품질 점검 Agent를 같이 만들어 팀에 이관
GAEO
AI 검색·답변에서 인용되는 콘텐츠 구조와 크롤러 정책, llms.txt와 구조화 데이터 설계
원문은 Fingerprint의 [How to detect Grok Bot AI agent traffic](https://fingerprint.com/blog/how-to-detect-grok-bot/)(2026.11.2)입니다. Fingerprint 제품의 탐지 설정 방법과 응답 형식은 원문에서 확인하세요. 크롤러 이름과 정책은 각 사 공식 문서(OpenAI, Anthropic)를 기준으로 했으며, 바뀔 수 있으니 반영 전에 다시 확인하시기 바랍니다.
## 근거와 출처
1. How to detect Grok Bot AI agent traffic — Fingerprint, 2026 (https://fingerprint.com/blog/how-to-detect-grok-bot/). 이 글의 기반 원문(Mark Bahl, 2026.11.2). Grok Bot의 작동 방식, 2026.10.9 무렵 Web Bot Auth 서명 중단, 탐지가 어려운 3가지 이유, 허용·마찰·차단 규칙
2. Bad Bot Report 2026: Bad Bots in the Agentic Age — Thales(Imperva), 2026 (https://www.imperva.com/blog/bad-bot-report-2026-bots-agentic-age/). 2025년 웹 트래픽 중 봇 53%(2024년 51%), 사람 47%. 악성 봇 40%. AI 에이전트를 세 번째 트래픽 유형으로 분류. 자동화 트래픽이 늘수록 참여·전환·수요 지표 해석이 어려워진다고 지적
3. State of Bot & Agent Security Report 2026(보도) — DataDome · SecureWorld, 2026 (https://www.secureworld.io/industry-news/bad-bots-faster-than-human-traffic). 2026년 상반기 AI 에이전트가 로그인·폼·장바구니·결제·계정 생성 페이지에 보낸 요청 6억 560만 건, 그중 로그인 페이지 51.7%
4. Overview of OpenAI Crawlers — OpenAI, 2026 (https://developers.openai.com/api/docs/bots). GPTBot(학습), OAI-SearchBot(검색), ChatGPT-User(사용자 요청). 사용자 요청 방문에는 robots.txt가 적용되지 않을 수 있음. IP 목록 공개
5. Does Anthropic crawl data from the web, and how can site owners block the crawler? — Anthropic, 2026 (https://support.claude.com/en/articles/8896518). ClaudeBot(학습), Claude-SearchBot(검색), Claude-User(사용자 요청). robots.txt 준수, 차단 시 검색 노출 감소 가능
6. Known bot-traffic exclusion — Google Analytics Help, 2026 (https://support.google.com/analytics/answer/9888366). GA4는 알려진 봇·스파이더 트래픽을 자동 제외. 끌 수 없고 제외된 양도 확인할 수 없음
7. AX WORKS 방법론과 3분 진단 — TROE, 2026 (https://troe.kr/ax/). 판단·설계·실행 3단계, H(사람 필수)·P(개선 대상) 표시
## 자주 묻는 질문
### Grok Bot은 무엇인가요?
xAI가 만든 AI 에이전트로, 사용자가 이름을 붙여 만든 봇이 클라우드 브라우저에서 로그인, 메일 처리, 폼 작성 같은 여러 단계의 작업을 대신합니다. 사용자가 오프라인이어도 계속 작동하고, 실제 계정 정보를 써서 사람처럼 폼을 채우기 때문에 웹사이트에서는 일반 방문자와 구분하기 어렵습니다.
### AI 크롤러를 robots.txt로 막으면 AI 에이전트도 막히나요?
일부만 막힙니다. 학습용 크롤러(GPTBot, ClaudeBot)와 검색용 크롤러(OAI-SearchBot, Claude-SearchBot)는 robots.txt 규칙을 따른다고 각 사가 밝히고 있지만, OpenAI는 사용자가 요청한 방문(ChatGPT-User)에는 robots.txt가 적용되지 않을 수 있다고 안내합니다. 사람처럼 브라우저를 쓰는 작업형 에이전트는 robots.txt만으로 관리된다고 보기 어렵습니다.
### AI 크롤러를 막으면 AI 검색 노출에 불리한가요?
어떤 크롤러를 막느냐에 따라 다릅니다. 학습용 크롤러만 막으면 모델 학습에서 빠지는 것이고, 검색용 크롤러나 사용자 요청 수집을 막으면 ChatGPT·Claude 같은 AI 답변에서 우리 콘텐츠가 인용될 기회가 줄어들 수 있습니다. 콘텐츠로 리드를 만드는 B2B 기업이라면 검색용은 열어 두는 편이 일반적입니다.
### GA4는 봇 트래픽을 자동으로 걸러 주지 않나요?
알려진 봇과 스파이더는 자동으로 제외합니다. 이 기능은 끌 수 없고, 얼마나 제외됐는지도 볼 수 없습니다. 다만 알려진 목록에 없는 봇이나 사람 브라우저처럼 움직이는 에이전트는 걸러지지 않을 수 있어서, 서버 로그와 리드 품질을 함께 봐야 합니다.
### AI 에이전트가 작성한 문의는 가짜 리드인가요?
꼭 그렇지는 않습니다. 실제 사람이 에이전트에게 업체 비교나 문의를 맡긴 경우라면 진짜 관심일 수 있습니다. 다만 사람이 직접 남긴 문의와 의도·단계가 다를 수 있으므로, 문의 폼에 확인 단계를 두고 후속 응답률로 품질을 따로 보는 것이 좋습니다.
### TROE는 AI 에이전트 트래픽 대응을 어떻게 돕나요?
GA4·광고 전환 설정과 리드 데이터를 점검해 에이전트 신호가 섞이는 지점을 찾고, AI 검색 노출과 데이터 품질을 함께 고려한 크롤러 정책과 영역별 확인 단계를 설계합니다. 이후 월간 점검 루틴을 담당자에게 넘깁니다.