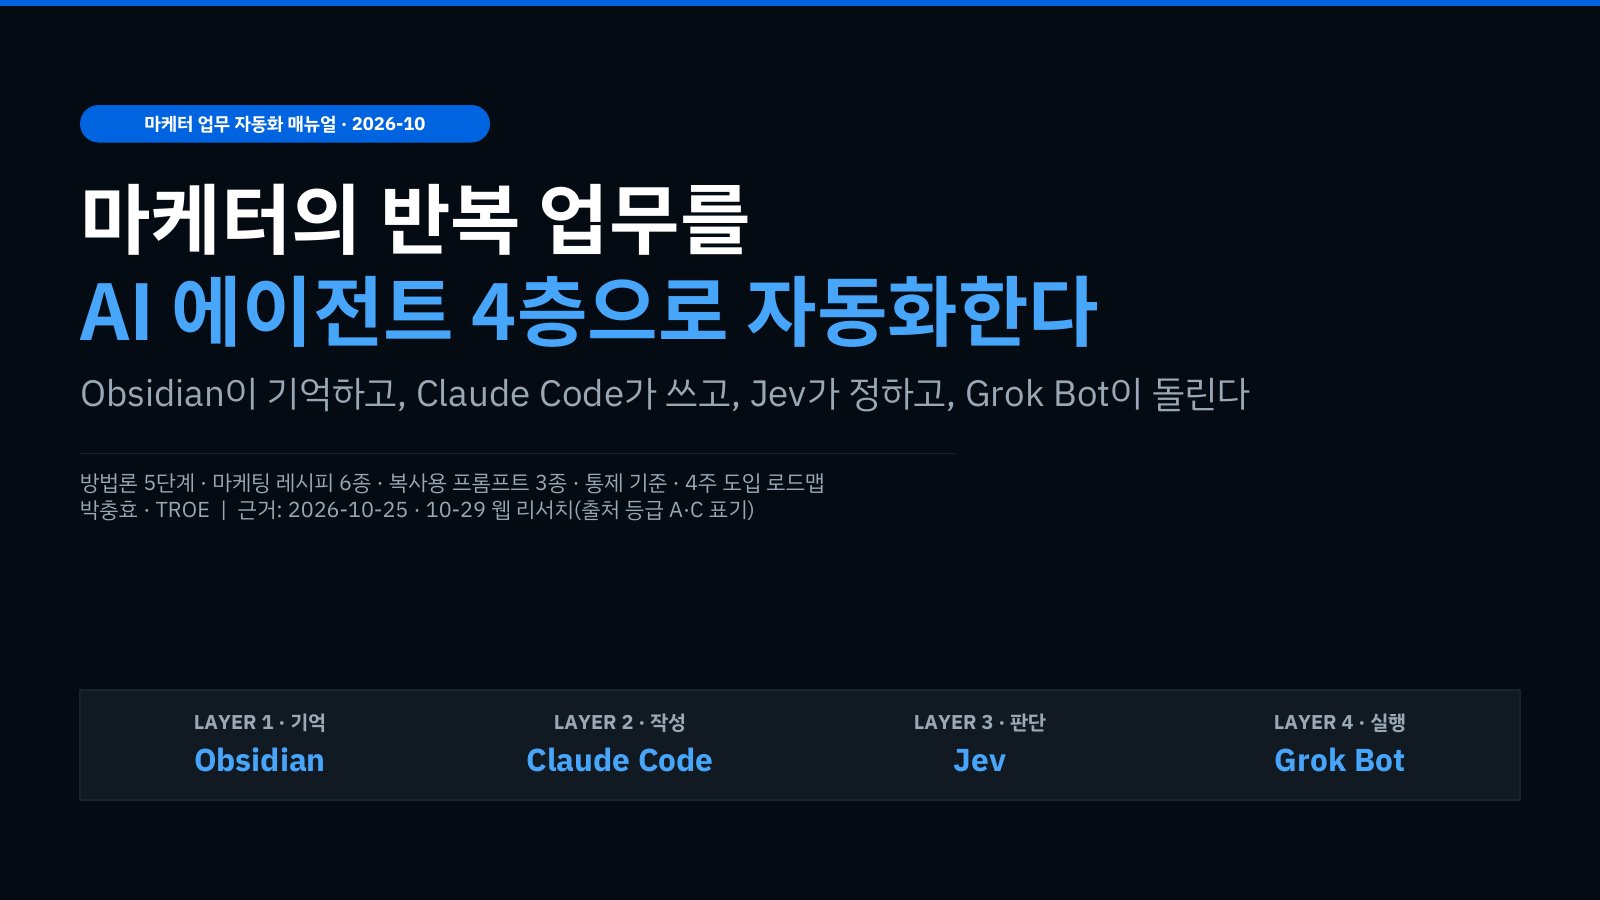
마케터 업무 자동화 4층 설계는 Obsidian 볼트가 기억하고, Claude Code가 글을 쓰고, Jev가 닫힌 질문에 답하고, Grok Bot이 클라우드에서 일을 돌리게 나누되, 되돌릴 수 없는 일은 사람이 승인하는 운영 방식입니다.
- 마케터 업무는 글을 만드는 '쓰기'와 정해진 선택지에서 고르는 '고르기'로 나뉩니다. 고르기를 결정 전용 모델에 맡기면 판단 한 건의 비용이 크게 줄어듭니다.
- 네 도구를 묶는 공식 통합은 없습니다(2026-10-29 기준). 그래서 한 줄로 잇지 않고 기억·작성·판단·실행의 층으로 나눠 역할이 겹치지 않게 합니다.
- 자동화 순서는 쪼개기, 기억하기, 저장하기, 판단 붙이기, 무인화입니다. 한 번 성공한 방법을 skill로 저장하기 전에 routine부터 거는 것이 가장 흔한 실패입니다.
- 발행·발송·결제·삭제는 모델의 신뢰도와 상관없이 사람이 승인합니다. Jev는 점수를 매길 수 있어도 승인하지 못합니다.
- 도입은 업무 하나를 4주 동안 기록, 저장, shadow, 무인화 순서로 옮기고, 호출당이 아니라 완료된 작업당 비용으로 잽니다.
마케터 업무 자동화 매뉴얼 PDF 내려받기 · 32쪽 · 약 0.4MB · 2026년 10월판. 방법론 5단계, 마케팅 레시피 6종, 복사용 프롬프트 3종, 통제 기준, 4주 도입 로드맵이 들어 있습니다. 이 글은 매뉴얼을 블로그로 읽기 쉽게 정리한 요약본입니다.
마케터 업무 자동화는 왜 쓰기와 고르기를 나누는 데서 시작하는가?
마케터의 하루는 쓰기보다 고르기가 많고, 고르기는 훨씬 싼 모델에 맡길 수 있기 때문입니다. 캠페인 카피 초안, 브랜드 톤에 맞춘 블로그 원고, 주간 리포트 문장은 열린 질문입니다. 반면 "이 리드에 지금 연락할까, 육성할까", "이 원고를 게시해도 되나", "이 클립은 어느 폴더로 보낼까"는 답이 정해진 닫힌 질문입니다.
| 구분 | 질문 유형 | 맡는 쪽 | 예시 |
|---|---|---|---|
| 쓰기 | 열린 질문 | Claude Code | 카피 초안, 원고 톤 수정, 리포트 문장, 랜딩 구조 제안 |
| 고르기 | 닫힌 질문 | Jev | 연락·육성·제외, 게시 여부, 폴더 분류, 리서치 계속 여부 |
결정 전용 모델인 Jev는 입력 100만 토큰당 $0.042이고 출력은 무료입니다. 그래서 예/아니오나 선택형 질문만 골라 맡깁니다. 글쓰기를 Jev에 맡기면 이 구조가 깨집니다.
네 도구는 어떤 층으로 쌓는가?
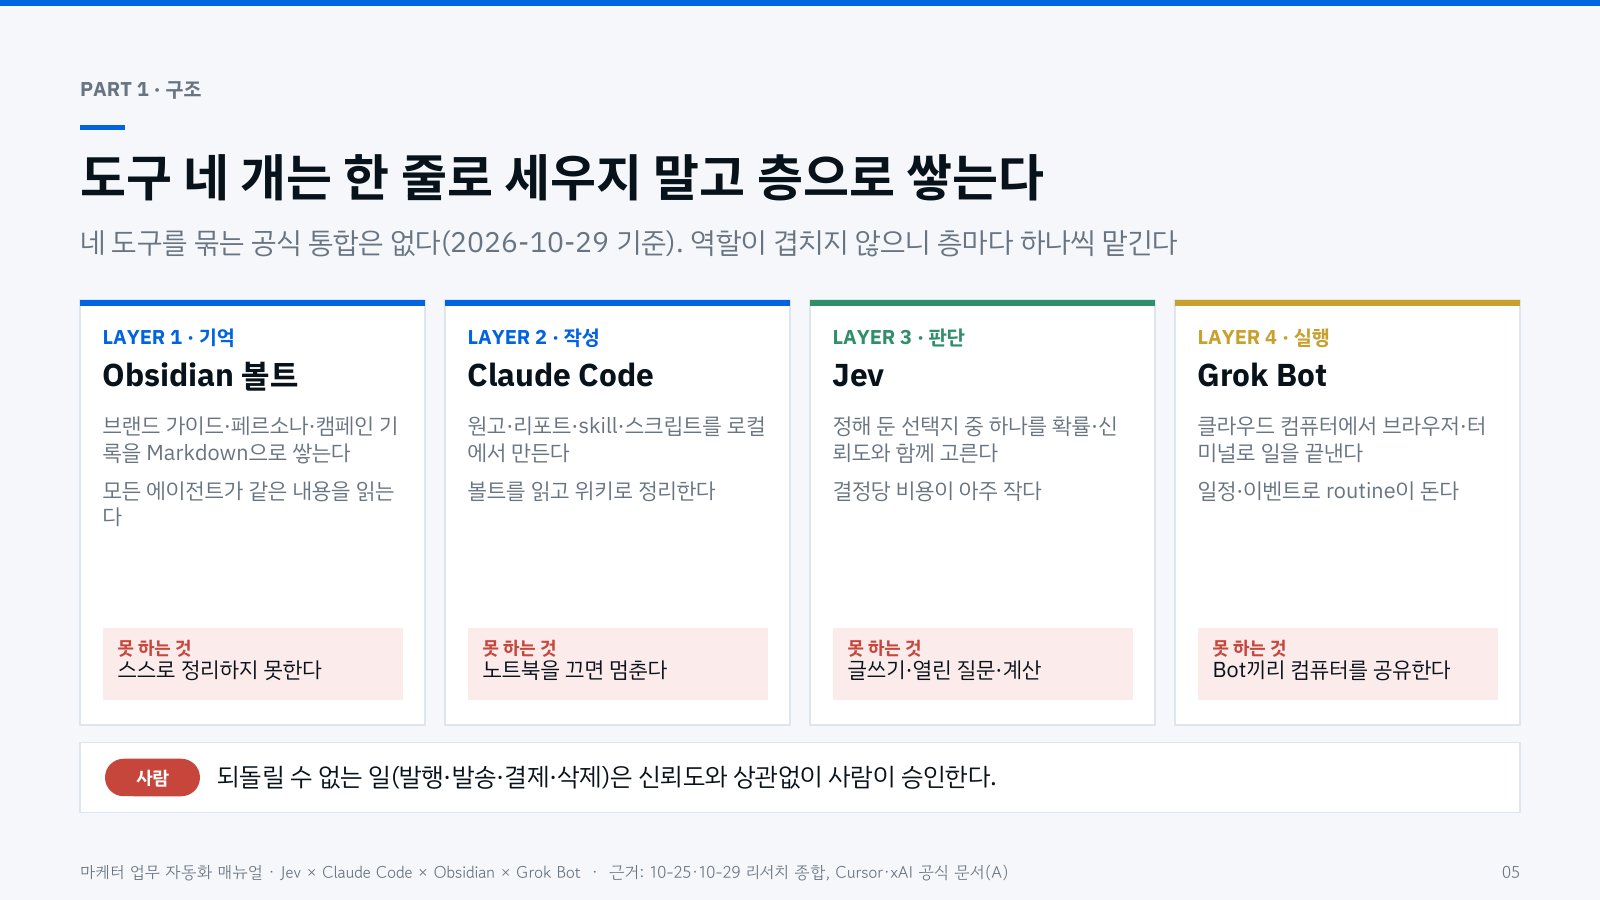
네 도구를 묶는 공식 통합은 없습니다(2026-10-29 기준). 대신 역할이 겹치지 않으니 층마다 하나씩 맡깁니다.
| 층 | 도구 | 하는 일 | 못 하는 것 |
|---|---|---|---|
| 1 · 기억 | Obsidian 볼트 | 브랜드 가이드·페르소나·캠페인 기록을 Markdown으로 쌓고, 모든 에이전트가 같은 내용을 읽는다 | 스스로 정리하지 못한다 |
| 2 · 작성 | Claude Code | 원고·리포트·skill·스크립트를 로컬에서 만든다 | 노트북을 끄면 멈춘다 |
| 3 · 판단 | Jev | 정해 둔 선택지 중 하나를 확률·신뢰도와 함께 고른다 | 글쓰기·열린 질문·계산 |
| 4 · 실행 | Grok Bot | 클라우드 컴퓨터에서 브라우저·터미널로 일을 끝내고, 일정·이벤트로 routine을 돌린다 | Bot끼리 컴퓨터를 공유한다 |
가장 자주 막히는 지점은 볼트 연결입니다. 공식 Obsidian CLI는 데스크톱 앱이 켜져 있어야 동작하므로, 클라우드에서 도는 Bot은 CLI로 볼트에 붙지 못합니다. 팀 볼트는 GitHub 저장소로 올리고 Bot은 저장소를 통해서만 읽고 쓰게 하면 이력과 롤백도 함께 남습니다.
어떤 마케팅 업무든 어떤 순서로 자동화하는가?
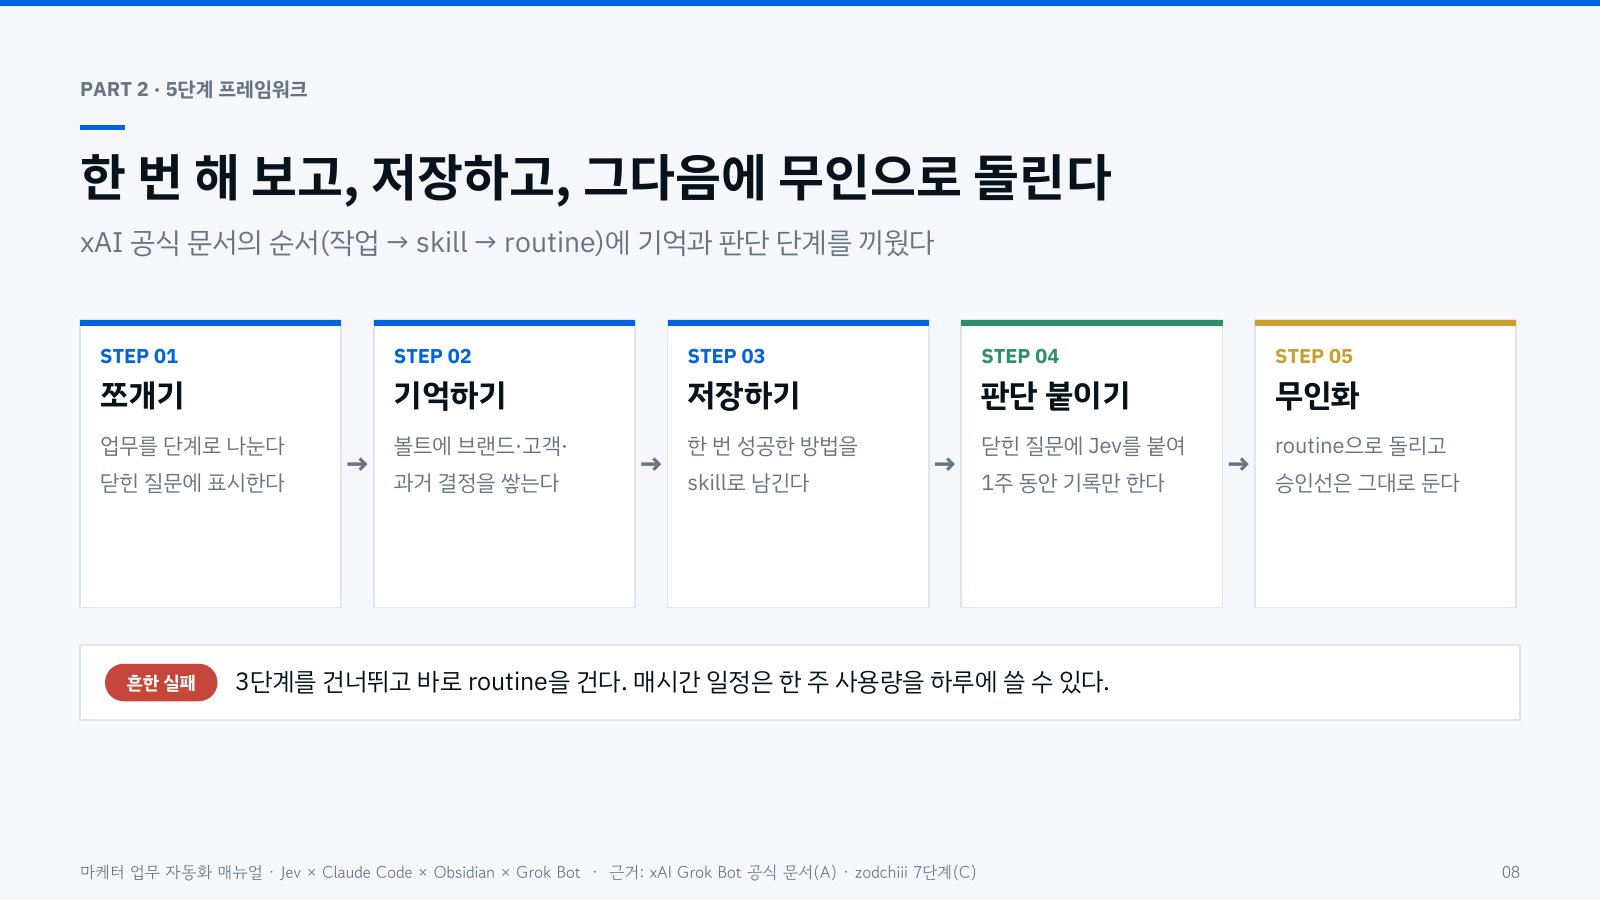
한 번 해 보고, 저장하고, 그다음에 무인으로 돌립니다. xAI 공식 문서의 순서(작업 → skill → routine)에 기억과 판단 단계를 끼운 5단계입니다.
- 쪼개기: 업무를 단계로 나누고 단계마다 담당을 정합니다. 닫힌 질문이 전체의 몇 %인지 먼저 셉니다. 쓰기가 대부분인 업무는 Jev로 얻는 게 거의 없습니다.
- 기억하기: 볼트에
brand/,personas/,campaigns/,decisions/,competitors/다섯 폴더와 규칙 파일CLAUDE.md(또는AGENTS.md)를 둡니다. 에이전트는 작업 전에 이 폴더를 먼저 읽습니다. - 저장하기: 사람이 한 번 성공시킨 방법을 skill로 남깁니다. skill에는 언제 쓰나, 입력과 권한, 작업 순서, 결과 검증, 돌려줄 결과, 승인이 필요한 일 여섯 가지를 적습니다. 승인 경계가 빠지면 위험합니다.
- 판단 붙이기: 닫힌 질문에 Jev를 붙이되 1주 동안 기록만 합니다. 선택지는 볼트에 이미 있는 이름을 쓰고,
ask_human같은 탈출구를 꼭 두고, 신뢰도 하한과 1·2위 격차를 함께 봅니다. 같은 입력도 확률이 0.03~0.04 흔들리기 때문입니다. - 무인화: routine으로 돌리되 승인선은 그대로 둡니다. 담당 Bot, 일정과 시간대, 입력 소스, 기대 결과, 승인 경계, 소스가 없을 때의 행동 여섯 가지를 확인하고 겁니다.
가장 흔한 실패는 3단계를 건너뛰고 바로 routine을 거는 것입니다. 매시간 일정 하나가 한 주 사용량을 하루에 쓸 수 있습니다.
| Grok Bot routine 항목 | 공식 값 |
|---|---|
| 시작 조건 | 일정, Slack·GitHub 이벤트, 이메일, webhook |
| Bot당 routine | 최대 50개, 실행 기록 20건 |
| 일정 간격 | 최소 5분 |
| 실행 한도 | 시간당 전체 300회, routine당 200회 |
| Test 버튼 | 실제 작업을 수행한다 |
마케팅 업무 중 무엇부터 자동화하면 좋은가?
자주 반복하는 업무 여섯 가지 중 우리 팀에 가장 아픈 것 하나만 고릅니다. 레시피마다 쓰는 층이 다릅니다.
| 레시피 | 하는 일 | 쓰는 층 | 사람이 하는 일 |
|---|---|---|---|
| 1 · 리드 분류 | 연락·육성·제외·검토 중 고른다 | Grok Bot + Jev | CRM 반영과 첫 연락 승인 |
| 2 · 게시 전 품질 게이트 | 브리프 위반·근거 없는 수치·비밀값이 있으면 멈춘다 | Claude Code + Jev | 게이트 연결 승인 |
| 3 · 경쟁사 모니터링 | 매주 읽고 대응 후보만 올린다 | Grok Bot routine | 대응 여부 판단, 채널 게시 |
| 4 · 콘텐츠 인박스 정리 | 클립의 폴더·태그를 제안한다 | Obsidian + Jev | 이동 수락 |
| 5 · 리서치 비용 상한 | 더 찾을지 멈출지 정한다 | Grok Bot + Jev | ask_human 건 판단 |
| 6 · 주간 리포트·팀 일지 | 무인 잡이 한 일을 한 줄로 남긴다 | 볼트 + routine | 교훈 승인 |
공개된 수치는 참고용으로만 봅니다. 리드 분류에서는 리드 3,412건에 질문 6개씩, 결정 20,472건을 15.7초·$0.41에 판정한 사례가 있지만 빌더 1인의 1회 실행(자기 보고)입니다. 리서치 비용 상한은 같은 방식 재시도 3회가 0회로, 읽은 페이지가 10개에서 4개로 줄었다는 측정이 있는데 이것도 로컬 1회 측정입니다. 우리 팀에서는 내 리드 100건으로 사람 판단과의 일치율부터 잽니다.
Obsidian용 Jev 도구는 모두 글을 고치지 않고 위치와 태그만 제안합니다. 노트 1,408개 볼트에서 태그의 62.7%가 한 번만 쓰였다는 실험이 있었고, 노트 229개를 판정하는 데 $0.0147이 들었습니다. 신뢰도 0.55 아래는 사람 검토로 넘깁니다.
바로 쓸 수 있는 프롬프트는 무엇인가?
매뉴얼의 복사용 프롬프트 3종입니다. 그대로 붙여 넣고 폴더 이름과 업무만 바꿔 쓰면 됩니다.
프롬프트 1 · Claude Code · 볼트 세팅
이 폴더를 마케팅 볼트로 정리해 줘.
— 폴더: brand/ · personas/ · campaigns/ · decisions/ · competitors/ · inbox/
— CLAUDE.md에 규칙을 적는다
  · 원고를 쓰기 전에 brand/tone.md를 먼저 읽는다
  · 수치에는 출처 링크를 붙인다
  · 고객 실명과 비밀값은 쓰지 않는다
— campaigns/에 날짜·예산·채널·결과·배운 점 템플릿을 만든다
— 기존 파일은 지우거나 덮어쓰지 않는다. 바꿀 내용을 먼저 목록으로 보여 준다
같은 규칙을 AGENTS.md에도 두면 Codex 같은 다른 에이전트도 같은 지침을 읽습니다.
프롬프트 2 · Grok Bot · skill 저장
방금 우리가 한 과정을 '주간 경쟁사 브리프' skill로 저장해 줘.
— 언제 쓰는지, 필요한 입력과 접근 권한, 작업 순서를 적는다
— 결과를 검증하는 방법과 돌려줄 형식을 적는다
— 규칙: 고객 연락과 채널 게시는 항상 내 승인을 받는다
— 브라우저 10페이지 이상, 재시도, 추가 Bot이 필요하면
  먼저 jev-usage-router에 다음 행동을 묻는다
— ask_human이 나오면 신뢰도와 상관없이 멈추고 나에게 묻는다
시연으로 만든 skill은 초안입니다. 실패 처리와 승인 경계를 직접 보탭니다.
프롬프트 3 · Claude Code · Jev 게이트
이 프로젝트의 도구 호출 앞에 Jev 게이트를 붙여 줘.
— 선택지는 allow · ask · block 세 가지
— 발송·게시·결제·삭제가 걸리면 Jev 답과 상관없이 ask
— Fail closed. If the Jev call errors or times out,
  ask me instead of running the tool.
— 모든 결정을 decisions.jsonl에 남긴다(API 키는 기록하지 않는다)
— 첫 1주는 shadow 모드: 결정은 기록만 하고 실행은 막지 않는다
Jev는 답을 고를 뿐 승인하지 못합니다. 하드 규칙은 코드가 먼저 처리합니다.
사람이 반드시 승인해야 하는 선은 어디인가?
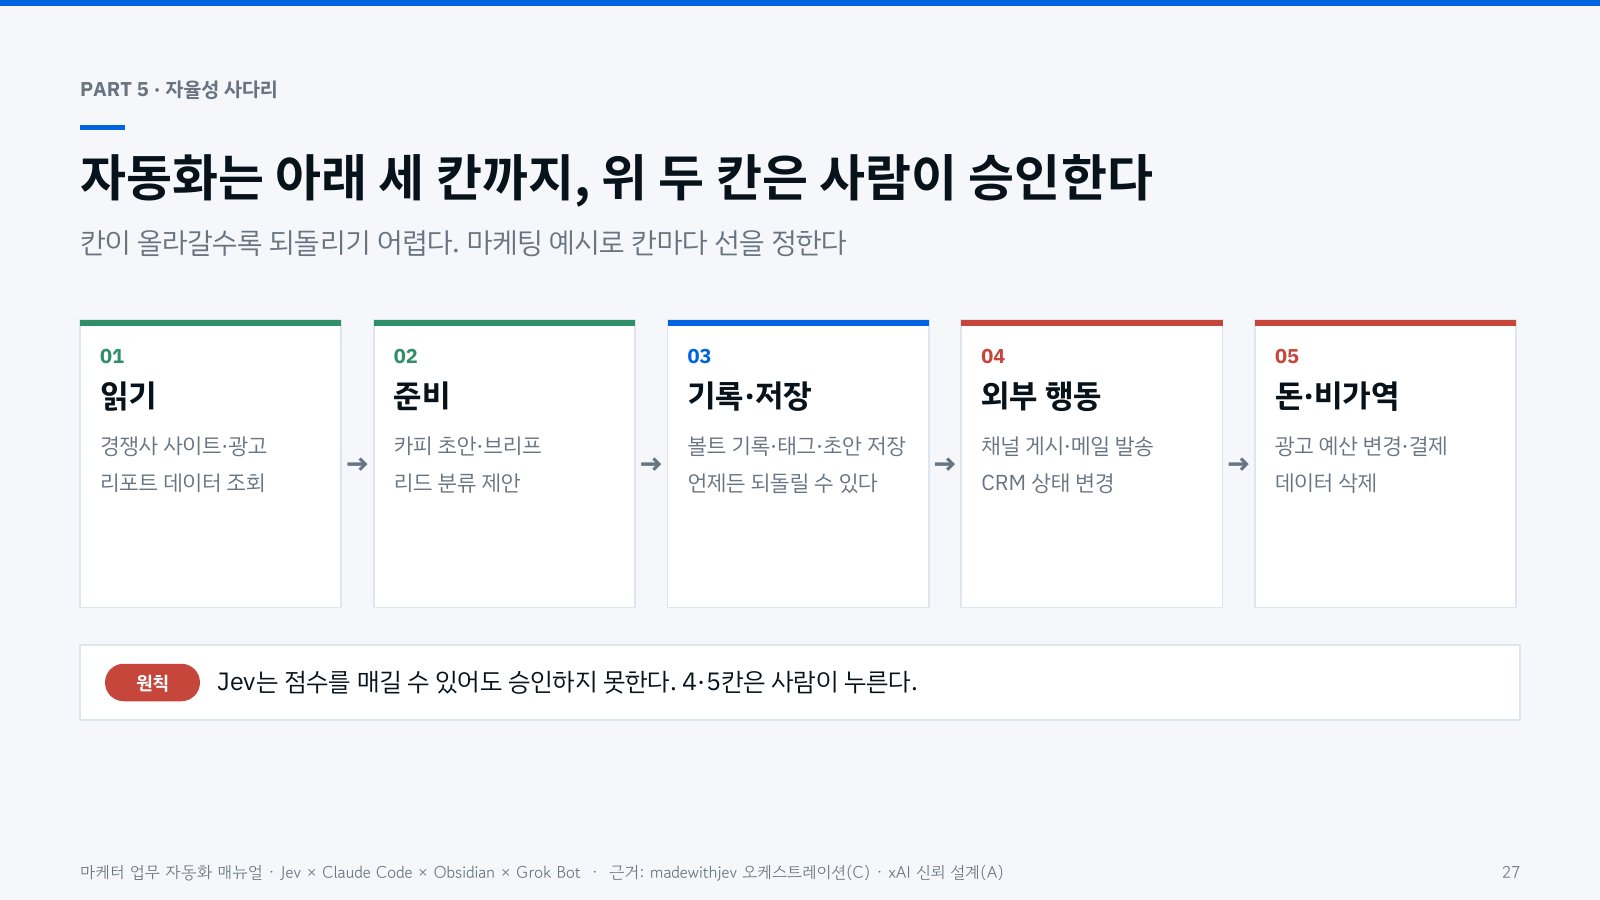
자동화는 자율성 사다리의 아래 세 칸까지이고, 위 두 칸은 사람이 누릅니다. 칸이 올라갈수록 되돌리기 어렵습니다.
| 칸 | 범위 | 마케팅 예시 | 담당 |
|---|---|---|---|
| 01 읽기 | 조회 | 경쟁사 사이트·광고, 리포트 데이터 | 자동 |
| 02 준비 | 초안 | 카피 초안, 브리프, 리드 분류 제안 | 자동 |
| 03 기록·저장 | 되돌릴 수 있는 쓰기 | 볼트 기록, 태그, 초안 저장 | 자동 |
| 04 외부 행동 | 밖으로 나가는 일 | 채널 게시, 메일 발송, CRM 상태 변경 | 사람 승인 |
| 05 돈·비가역 | 되돌릴 수 없는 일 | 광고 예산 변경, 결제, 데이터 삭제 | 사람 승인 |
도입 전에는 기술보다 데이터가 어디로 나가는지와 누가 승인하는지를 먼저 팀과 합의합니다.
| 리스크 | 무슨 일이 생기나 | 대응 |
|---|---|---|
| 데이터 반출 | 노트 본문 최대 6,000자, 메시지 최대 4,000자가 외부 API로 나간다 | 고객사 폴더는 제외하고 로컬 마스킹을 먼저 한다 |
| 공유 클라우드 컴퓨터 | Grok Bot의 모든 Bot이 같은 파일·로그인을 본다 | 민감 자료는 올리지 않고 고객별 계정 분리를 검토한다 |
| 확신 있는 오답 | 잘못 짠 선택지는 오류 없이 높은 신뢰도로 틀린다 | 하한 이상도 일부를 큰 모델로 다시 검사한다 |
| 사용량 폭주 | 넓은 트리거 하나가 한 주 사용량을 하루에 쓴다 | 채널·문구를 좁히고 일정은 하루 단위부터 |
| 거짓 절감 | 싼 판정만 고르면 실패 전까지 효율적으로 보인다 | 완료된 작업당 비용으로 잰다 |
| 이름 혼동 | Grok Bot(업무 Bot)과 Grok Build(코딩 에이전트)는 다르다 | 자료·교육에서 둘을 구분해 적는다 |
4주 안에 어떻게 도입하고 무엇으로 재는가?
업무 하나를 4주 동안 기록 → 저장 → shadow → 무인화로 옮깁니다. 매주 끝나는 산출물이 있어야 다음 주로 넘어갑니다.
| 주차 | 할 일 | 산출물 |
|---|---|---|
| 1 · 쪼개기·기억 | 업무 1개를 단계로 분해하고 닫힌 질문 비율을 센다. 볼트 폴더와 CLAUDE.md를 만든다 |
분해표, 볼트 |
| 2 · 저장·작성 | 사람이 3번 성공시킨 방법을 skill로 저장하고 게시 전 게이트를 붙인다 | skill 1개 |
| 3 · 판단 shadow | Jev는 기록만 한다. 매일 일치율과 ask_human을 보고, 어긋난 질문은 선택지부터 고친다 |
결정 로그 7일치 |
| 4 · 무인화 | routine 1개를 켜고 킬 스위치 2개를 유지한다. 첫 주는 매일 결과를 확인한다 | 첫 무인 실행 결과 |
측정은 호출당이 아니라 완료된 작업당 비용으로 합니다. 싼 판정기는 실패하기 전까지 늘 효율적으로 보이기 때문입니다.
| 지표 | 보는 법 |
|---|---|
| 완료된 작업당 비용 | 모델·Bot 사용량을 끝까지 끝난 작업 수로 나눈다 |
| 사람 판단과의 일치율 | shadow 기간에 같은 건을 사람과 Jev가 각각 판정한다 |
ask_human 비율 |
너무 높으면 선택지가 부족하고, 0이면 하한이 너무 낮다 |
| 재시도·중단 횟수 | stop_retry가 성공했을 시도를 끊지 않았는지 확인한다 |
이번 주에 무엇부터 하면 되는가?
반복 업무 하나를 골라 단계로 쪼개고, 닫힌 질문에 동그라미를 치는 것부터 시작합니다. 기억할 원칙은 세 가지입니다. 쓰기와 고르기를 나누고, 한 번 해 보고 저장한 다음에 무인화하고, 되돌릴 수 없는 일은 사람이 승인합니다.
개인 단위의 하루·주 리듬과 통제 규칙은 마케터 개인 OS 가이드에서, 팀 단위 파일럿 순서는 마케팅 AI Agent 도입 로드맵에서 이어 읽을 수 있습니다. 팀이 이 방법을 직접 만들고 운영하게 하려면 Academy를, 첫 업무를 정하는 일부터 함께하려면 Blueprint를 참고하세요. 우리 팀이 어느 단계에 있는지는 3분 진단으로 먼저 확인할 수 있습니다.
근거와 출처
- 마케터 업무 자동화 매뉴얼 — Jev × Claude Code × Obsidian × Grok Bot (32쪽 PDF) — TROE, 2026. 이 글의 원본. 2026-10-25·10-29 웹 리서치 기준, 출처 등급 A·C 표기
- Grok Bot — Skills, routines and automations — xAI, 2026. skill 체크리스트, routine 시작 조건·개수·간격·실행 한도, Test 버튼 동작(공식 문서, 등급 A)
- Obsidian CLI · Obsidian Headless 도움말 — Obsidian, 2026. CLI는 앱 실행이 필요하고 Headless는 Node.js 22+·Sync 구독·오픈베타라는 근거(공식 문서, 등급 A)
- obsidian-synapse 이슈 #558 — GitHub, 2026. Jev 입력 100만 토큰당 $0.042, 출력 무료(공식 가격과 대조, 등급 A)
- Jev agent orchestration — madewithjev, 2026. 리드 3,412건 × 질문 6개 = 20,472건을 15.7초·$0.41에 판정한 빌더 1인의 1회 실행(자기 보고, 등급 C)
- grok-bot-jev README — GitHub · Bodila51, 2026. 재시도 3→0, 페이지 10→4, 53.8초→4.1초. 로컬 1회 측정이며 벤치마크가 아님(등급 A)
- How to wire Jev into Grok Bot — zodchiii, 2026. Choice 질문 예시, shadow 운영, 도입 단계(제3자 가이드, 등급 C)
- Jev the Janitor README — GitHub · kylehovance-ai, 2026. 노트 229개 판정 비용 $0.0147, 신뢰도 하한 0.55(데모 볼트 1회, 등급 A)
- Obsidian 태그 정리 실험 노트 — GitHub Gist · snaga, 2026. 노트 1,408개 볼트에서 태그 62.7%가 한 번만 쓰임(1인 실험, 등급 A)
- JEV Inbox Router · Jevault · obsidian-second-brain README — GitHub, 2026. Obsidian용 Jev 도구의 기본 동작(제안 후 수락), 외부 전송 글자 수, 공유 작업 일지 구조(등급 A)
자주 묻는 질문
네 도구를 모두 써야 자동화를 시작할 수 있나요?
아니요. Obsidian 볼트와 Claude Code만으로 1~2주차를 진행할 수 있습니다. 닫힌 질문이 적은 업무라면 Jev를 붙여도 얻는 것이 거의 없으므로, 먼저 업무를 쪼개 닫힌 질문의 비율부터 셉니다.
클라우드에서 도는 Grok Bot이 내 노트북의 Obsidian 볼트를 읽을 수 있나요?
직접은 못 읽습니다. 공식 Obsidian CLI는 데스크톱 앱이 켜져 있어야 동작하므로, 팀 볼트를 GitHub 저장소로 올리고 Bot은 저장소를 통해서만 읽고 쓰게 하는 방식을 권합니다.
Jev가 높은 신뢰도로 답하면 그대로 실행해도 되나요?
되돌릴 수 있는 일까지만 그렇습니다. 잘못 짠 선택지는 오류 없이 높은 신뢰도로 틀리기 때문에, 외부 행동과 돈이 걸린 일은 사람이 승인하고 하한 이상의 판정도 일부는 큰 모델로 다시 검사합니다.
Grok Bot과 Grok Build는 같은 도구인가요?
다른 도구입니다. Grok Bot은 클라우드 컴퓨터에서 브라우저·터미널로 일을 끝내는 업무 Bot이고, Grok Build는 터미널 코딩 에이전트입니다. 교육 자료와 사내 문서에서 둘을 구분해 적어야 합니다.
매뉴얼 원본은 어디서 받을 수 있나요?
이 글 상단의 '원본 자료'에서 32쪽 PDF를 내려받을 수 있습니다. 복사용 프롬프트 3종은 이 글 본문에도 그대로 실었습니다.