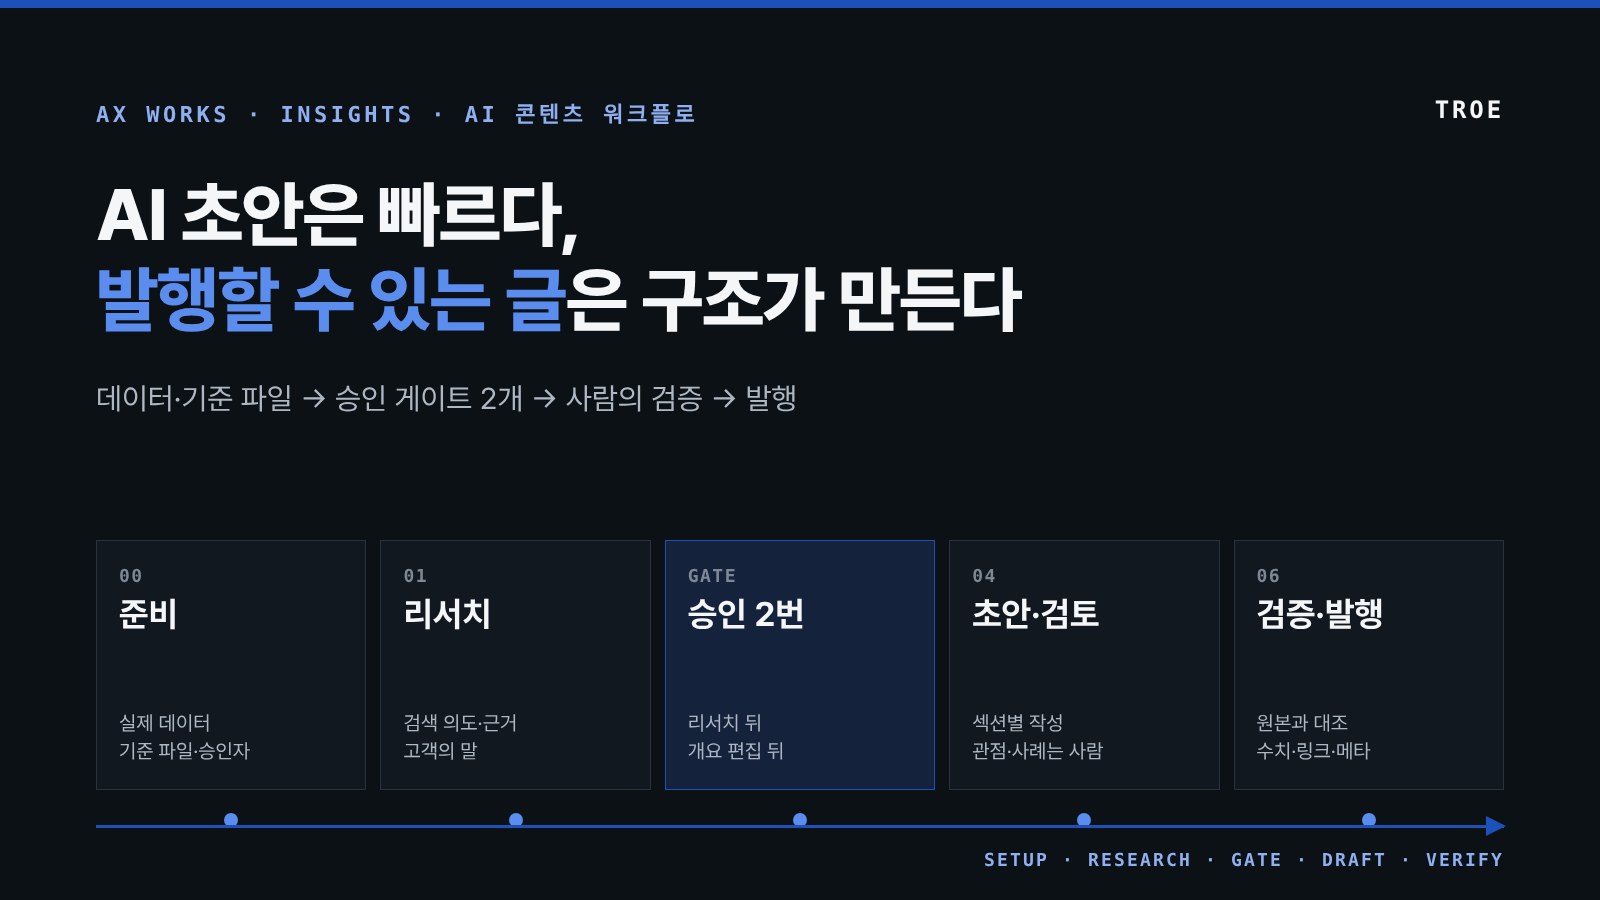
AI 콘텐츠 제작 워크플로는 AI에게 실제 데이터와 브랜드 기준 파일을 먼저 주고, 리서치와 개요 단계에서 사람이 두 번 승인한 뒤 초안을 쓰게 하며, 수치·링크·제품 정보·메타데이터를 사람이 원본과 대조해 검증하고 발행하는 콘텐츠 운영 방식입니다.
- AI 콘텐츠의 품질은 첫 프롬프트 전에 정해집니다. 실제 데이터 연결, 브랜드 기준 파일, 사람이 멈출 지점 세 가지를 먼저 준비합니다.
- 워크플로는 리서치, 개요, 개요 편집, 초안, 검토, 검증, 발행 순서로 돌고, 리서치 뒤와 개요 편집 뒤에 사람의 승인 게이트 두 개를 둡니다. 원문 저자는 두 게이트에 40~50분이 든다고 밝혔습니다.
- 검증은 AI에게 맡기지 않습니다. 수치와 주장, 내부 링크, 제품·서비스 정보, 메타데이터를 사람이 원본과 대조합니다.
- 구글은 AI로 만들었다는 이유만으로 콘텐츠를 불리하게 보지 않지만, 가치를 더하지 않는 페이지를 대량으로 만들면 대규모 콘텐츠 악용 정책에 걸릴 수 있습니다.
- 기존 글 업데이트는 새 글과 다르게 성과 데이터에서 출발해, 순위를 지키는 제목은 남기고 진단된 섹션만 고칩니다. 반복되는 단계는 단계마다 하나씩 Agent 스킬로 만들되 승인 지점은 남깁니다.
AI로 블로그 초안을 쓰는 데는 몇 분이면 충분합니다. 문제는 그 초안을 그대로 발행할 수 있느냐입니다. 구 제품명이 섞여 있고, 출처를 넘어서는 주장이 있고, 우리 회사가 할 말이 빠져 있습니다. Semrush가 11월 17일 공개한 AI 콘텐츠 제작 워크플로는 이 문제의 원인을 프롬프트가 아니라 준비와 승인 구조에서 찾습니다. 이 글은 그 워크플로를 국내 마케팅 팀의 콘텐츠 업무에 맞게 다시 정리한 것입니다.
ACT 1 · 문제 — 초안은 빠른데 발행은 늦다
AI로 쓴 콘텐츠는 왜 그대로 발행하기 어려운가?
결과물의 품질이 첫 프롬프트를 쓰기 전에 이미 정해지기 때문입니다. 원문은 AI 콘텐츠가 실패하는 이유를 모델 성능이 아니라 준비 부족에서 찾습니다. 최신 데이터 없이 쓰면 일반론이 되고, 회사 기준을 모르면 틀린 이름과 표현이 들어가고, 사람이 멈춰 확인하는 지점이 없으면 잘못된 방향 위에 글 전체가 쓰입니다.
원문이 정리한 흔한 실패 네 가지를 국내 마케팅 팀의 상황으로 옮기면 이렇습니다.
| 흔한 실패 | 이렇게 나타난다 | 막는 방법 |
|---|---|---|
| 준비를 건너뜀 | 바뀐 서비스명, 끝난 프로모션, 예전 가격이 초안에 들어감 | 서비스·제품 표기 규칙과 쓰지 않는 표현 목록을 기준 파일로 제공 |
| 검증 안 한 수치를 믿음 | 숫자는 맞게 옮겼는데 주장이 데이터보다 넓어짐 | 수치마다 원본을 열어 같은 범위를 말하는지 확인 |
| 몇 번 잘 되자 승인 단계를 없앰 | 엉뚱한 경쟁사나 검색 의도로 개요가 짜임 | 리서치 뒤와 개요 뒤 승인은 계속 유지 |
| 업데이트를 새로 쓰기로 처리 | 검색 유입을 만들던 제목까지 바뀌고, 정작 떨어진 섹션은 그대로 | 성과 데이터로 진단한 섹션만 수정 |
첫 프롬프트 전에 무엇을 준비하는가?
실제 데이터 연결, 기준 파일, 사람이 멈출 지점 세 가지입니다. 이 셋이 있으면 AI는 일반론 대신 우리 회사의 데이터와 기준으로 쓰고, 사람은 결정이 필요한 지점에서만 시간을 씁니다.
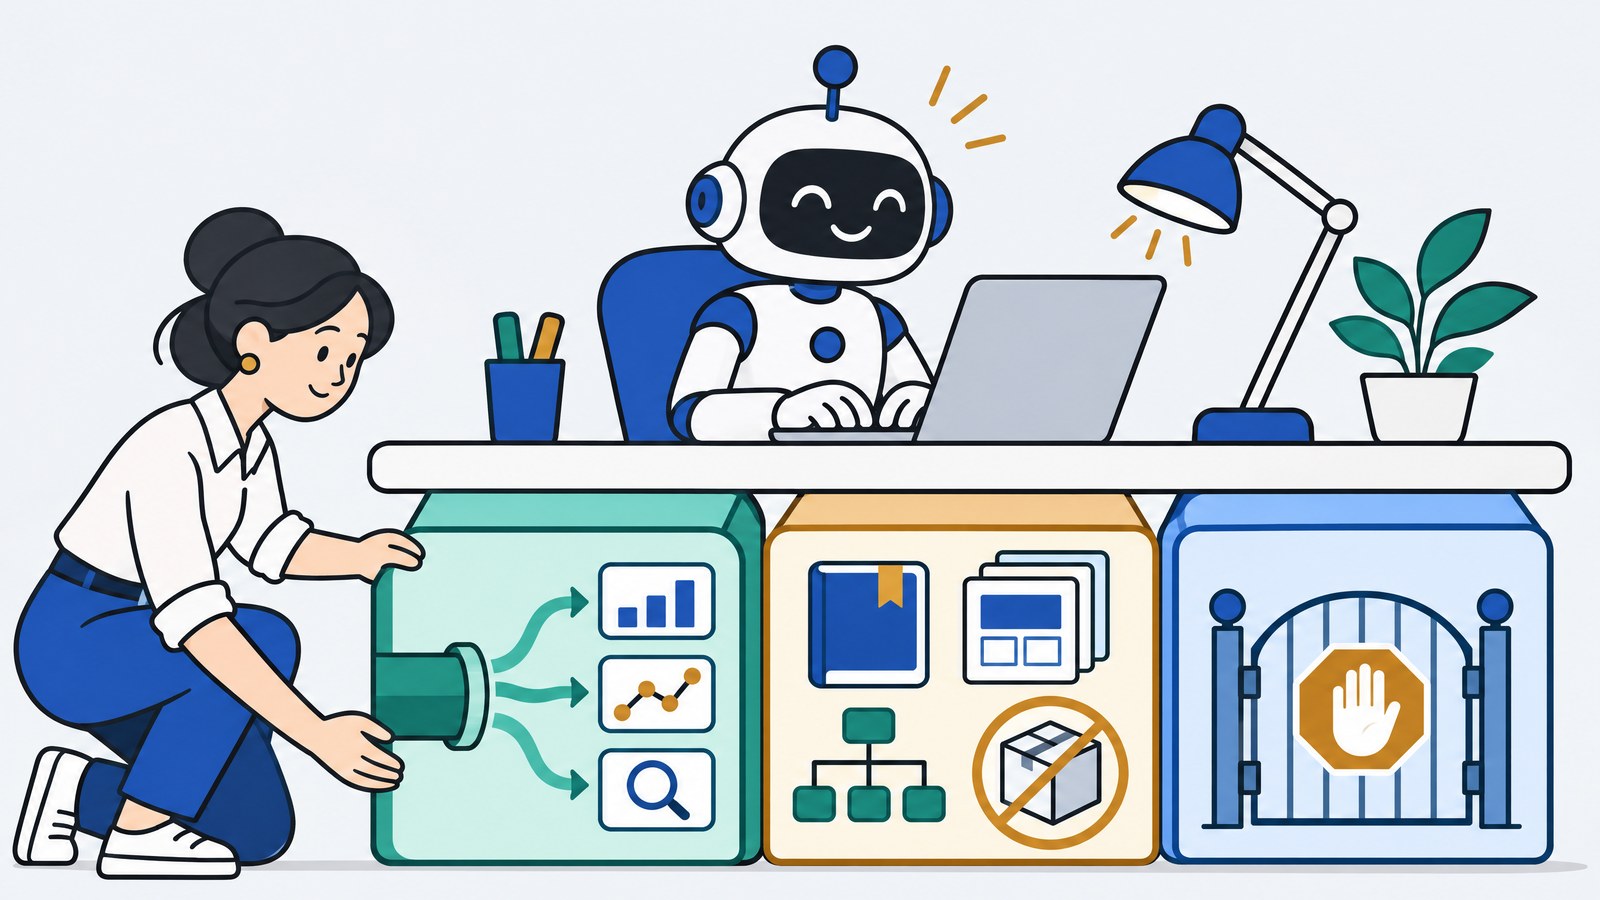
검색·성과 데이터에 연결한다
구글 서치 콘솔, 네이버 서치어드바이저, 네이버 데이터랩, 검색 도구의 키워드·경쟁 데이터를 연결합니다. 요청할 때 필요한 지표를 정확히 적고, 가져오지 못한 페이지는 표시하게 하고, 가져온 데이터와 AI의 해석을 따로 적게 합니다. 영업 통화, CS 문의, 리뷰에 나온 고객의 말도 함께 줍니다.
회사 기준을 파일로 준다
브랜드 톤 가이드, 브리프 템플릿, 사이트맵, 서비스·제품 표기 규칙, 더 이상 쓰지 않는 이름과 표현 목록을 마크다운 파일로 정리해 AI가 늘 참고하게 둡니다. 원문에서도 초안이 예전 도구 이름을 쓴 것을 이 파일로 잡아냈습니다.
사람이 승인할 곳을 정한다
리서치가 끝난 뒤와 개요를 편집한 뒤, 두 번 멈추고 사람이 승인합니다. 원문은 워크플로가 안정돼 보여도 이 게이트를 없애지 말라고 강조합니다. 승인자는 사람 이름으로 정해 둡니다.
기준 파일은 한 번 잘 만들어 두면 블로그뿐 아니라 SNS, 뉴스레터, 광고 문구에도 그대로 씁니다. AI에게 업무를 지시하는 문서를 어떻게 구성하는지는 『AI AGENT를 지휘하는 마케터』의 R-G-C-T-O-R 업무 지시서에서 이어서 볼 수 있습니다.
ACT 2 · 흐름 — 두 번 멈추는 7단계
AI 콘텐츠 제작 워크플로는 어떤 순서로 돌아가는가?
리서치, 개요, 개요 편집, 초안, 검토, 검증, 발행의 7단계이고, 리서치 뒤와 개요 편집 뒤에 승인 게이트가 있습니다. AI가 빨리 할 수 있는 일은 AI에게 맡기고, 방향이 정해지는 순간에는 사람이 멈춰 확인하는 구조입니다.
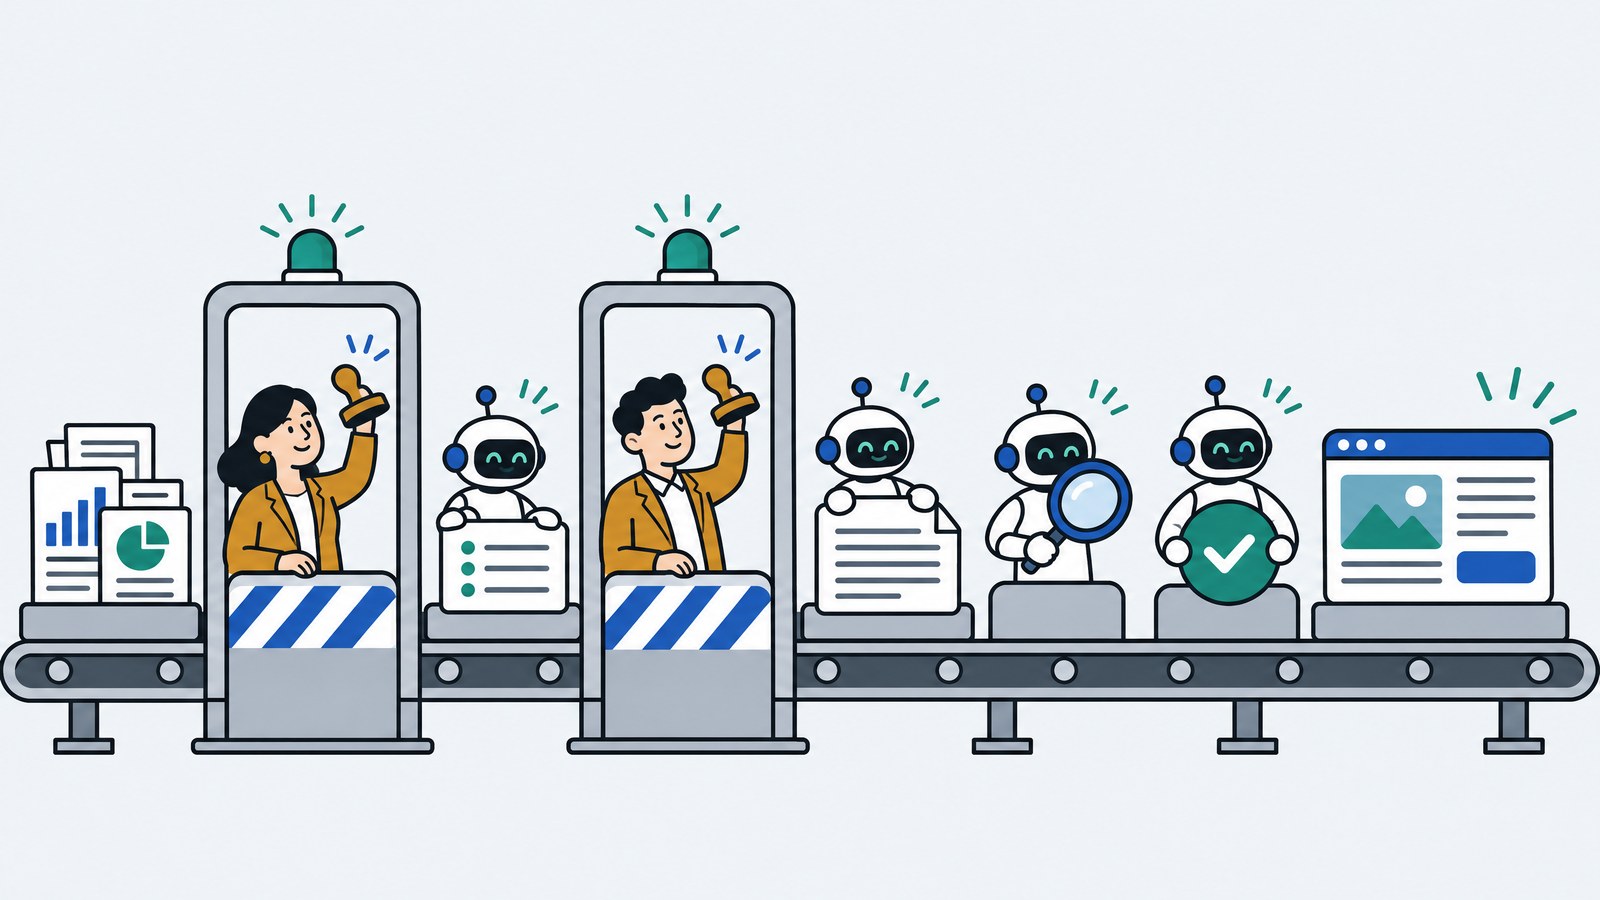
| 단계 | AI가 하는 일 | 사람이 하는 일 | 남는 것 |
|---|---|---|---|
| 1. 리서치 | 키워드·검색 결과·경쟁 글 수집, 고객 표현 정리 | 검색 의도가 다른 결과 제외 지시 | 리서치 파일 |
| 게이트 1 | — | 결론 확인, 약한 근거 삭제, 미해결 질문 정리 | 승인된 리서치 |
| 2. 개요 | 리서치와 브리프 템플릿으로 개요 작성 | — | 개요 초안 |
| 3. 개요 편집 | — | 순서, 범위, 우선순위, 근거, 다룰 제품 선택 수정 | 편집한 개요 |
| 게이트 2 | — | 논지·범위·순서 최종 승인 | 승인된 개요 |
| 4. 초안 | 승인된 개요대로 섹션별 작성 | 관점, 직접 겪은 사례, 제품 판단 제공 | 초안 |
| 5. 검토·수정 | 구체적 맥락을 받아 섹션 고쳐 쓰기 | 독자적 분석과 경험이 들어갔는지 확인 | 수정본 |
| 6. 검증 | 확인할 수치·링크·주장 목록 표시 | 원본과 대조해 판단 | 검증 목록 |
| 7. 발행 | — | 서식, 이미지, 링크, CTA, 제목 구조 최종 확인 | 발행 글 |
원문 저자는 두 게이트를 합쳐 40~50분이 걸린다고 밝혔습니다. 리서치 확인에 10~20분, 개요 편집에 30분 정도입니다. 저자의 작업 경험에서 나온 수치라 팀마다 다를 수 있지만, 사람의 시간이 어디에 쓰이는지 보여 줍니다. 초안 작성이 아니라 방향을 정하는 데 씁니다.
두 번의 승인 게이트에서 사람은 무엇을 확인하는가?
게이트 1에서는 근거를, 게이트 2에서는 논지를 봅니다. 원문 사례가 좋은 예입니다. 리서치 단계에서 검색 도구는 한 키워드를 구매 의도로 분류했지만, 실제 검색 결과는 정보성 글이 대부분이었습니다. 대행사를 찾는 검색어처럼 의도가 다른 결과도 섞여 있었습니다. 게이트 1에서 이런 것을 걸러 내지 않으면, 개요와 초안이 모두 잘못된 독자를 향합니다.
- 게이트 1 · 리서치 승인 검색 결과의 실제 의도가 우리가 쓰려는 글과 맞는가
- 게이트 1 근거가 약하거나 오래된 출처를 지웠는가, 데이터와 AI의 해석이 섞이지 않았는가
- 게이트 1 고객이 실제로 쓰는 말(문의, 리뷰, 영업 통화)이 반영됐는가
- 게이트 2 · 개요 승인 이 글의 한 줄 주장이 분명하고, 섹션 순서가 그 주장을 따라가는가
- 게이트 2 다루지 않을 범위를 정했는가, 소개할 우리 서비스나 도구 선택이 맞는가
- 게이트 2 우리만 말할 수 있는 관점과 사례가 들어갈 섹션이 있는가
팀의 콘텐츠 유형 하나로 기준 파일과 게이트를 같이 만듭니다
TROE는 2004년부터 브랜드·콘텐츠 전략을 자문해 왔습니다. 블로그, 뉴스레터, SNS 중 반복 빈도가 가장 높은 콘텐츠 하나를 골라 브랜드 기준 파일과 브리프 템플릿, 두 번의 승인 게이트, 검증 체크리스트를 함께 만들고, 실제 글 몇 편으로 돌려 보며 다듬습니다.
ACT 3 · 검증 — AI가 자기 숙제를 채점하지 않게
AI가 쓴 초안은 어떻게 검증하는가?
AI에게 확인할 대상을 표시하게 하고, 맞는지는 사람이 원본을 열어 판단합니다. 원문은 모델이 자기 주장을 스스로 판단하게 두지 말라고 권합니다. 흥미로운 사례도 있습니다. AI가 초안의 한 정보를 틀렸다고 표시했는데, 공식 도움말을 확인해 보니 초안이 맞았습니다. AI는 틀린 것을 맞다고도, 맞는 것을 틀리다고도 할 수 있습니다.
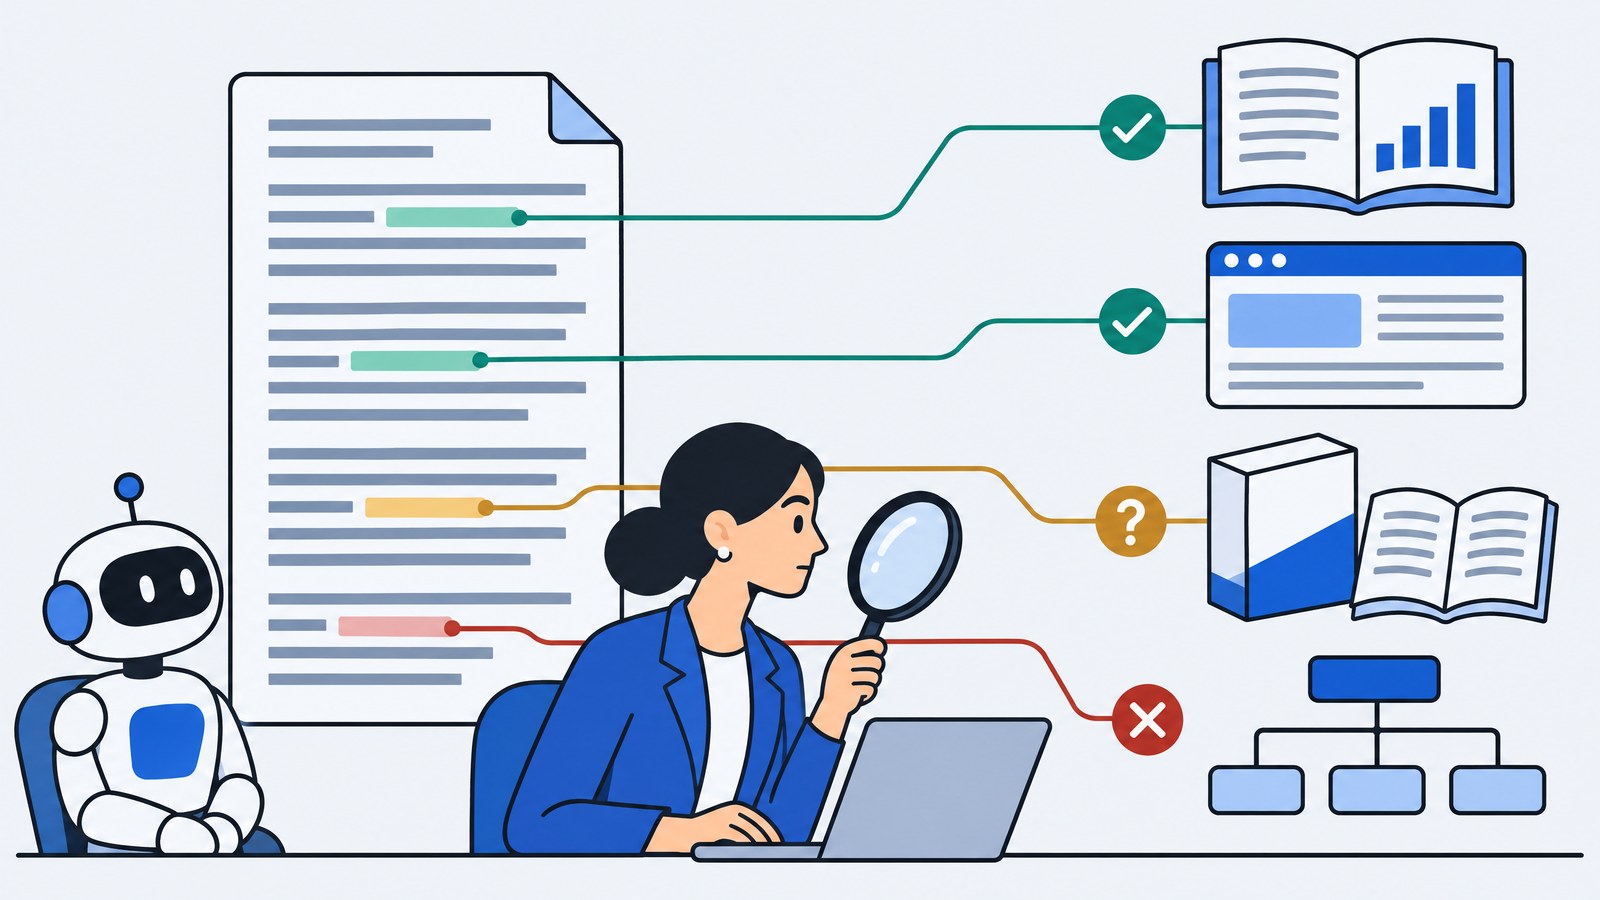
| 검증 항목 | 무엇을 확인하나 | 어디와 대조하나 |
|---|---|---|
| 수치·주장 | 원본이 초안이 말하는 범위를 정확히 뒷받침하는가 | 원 보고서·조사 페이지(조사 기관, 기간, 대상) |
| 내부 링크 | 링크가 살아 있고 맥락에 맞는 글로 가는가 | 현재 사이트맵 |
| 제품·서비스 정보 | 이름, 기능, 가격, 조건이 지금 기준인가 | 최신 공식 문서, 가능하면 제품 화면 |
| 메타데이터 | 제목 태그, 설명, 구조화 데이터, 이미지 대체 텍스트가 정확한가 | 발행 전 페이지 소스 |
수치를 확인하는 질문은 AI가 만든 마케팅 리포트, 출처부터 물어보세요에 4가지 원칙으로 정리했습니다. 콘텐츠의 수치 검증에도 그대로 쓸 수 있습니다.
구글은 AI로 만든 콘텐츠를 불리하게 보는가?
만든 방식 때문에 불리하게 보지는 않습니다. 구글 검색 센터는 생성형 AI가 주제를 조사하고 독창적인 콘텐츠에 구조를 더하는 데 유용할 수 있다고 안내합니다. 동시에 생성형 AI로 사용자에게 가치를 더하지 않는 페이지를 대량으로 만들면 대규모 콘텐츠 악용(scaled content abuse) 스팸 정책을 위반할 수 있다고 경고합니다. 2023년 안내에서도 순위 조작이 주된 목적인 자동 생성은 정책 위반이며, 콘텐츠를 누가·어떻게·왜 만들었는지 생각해 보라고 했습니다.
마케팅 팀에게 이 말은 분명합니다. 빨리 많이 만드는 것보다, AI가 만든 초안에 우리만의 경험과 판단, 검증을 더하는 과정이 검색에서도 자산이 됩니다. AI 검색과 답변에서 인용되기 쉬운 구조는 SEO·AEO·GEO 실무 가이드와 도서 블로그의 GEO 콘텐츠 구조 가이드에서 이어 볼 수 있습니다.
기존 글 업데이트는 새 글과 무엇이 다른가?
출발점이 다릅니다. 새 글은 키워드에서 시작하지만, 업데이트는 기존 URL과 성과 데이터에서 시작합니다. 가장 큰 위험은 이미 성과를 내는 페이지를 망가뜨리는 것입니다. 그래서 무엇을 새로 쓸지가 아니라 무엇이 떨어졌고 무엇이 빠졌는지를 진단합니다.
ACT 4 · 실행 — 손으로 돌린 다음 스킬로
반복되는 단계는 어떻게 Agent 스킬로 만드는가?
단계마다 하나씩 만들고, 각 스킬 끝에 승인 지점을 남깁니다. 원문은 리서치, 브리프, 초안, 검증, 업데이트 다섯 가지 스킬을 제안합니다. Claude의 스킬이나 ChatGPT의 프로젝트처럼 반복 지시를 저장하는 기능에 넣어 두고, 같은 콘텐츠 유형에서 계속 씁니다.
| 스킬 | 입력 | 출력 | 멈추는 곳 |
|---|---|---|---|
| 리서치 | 대표 키워드, 고객 표현 자료 | 리서치 파일 | 게이트 1 |
| 브리프 | 승인된 리서치, 브리프 템플릿 | 브리프와 개요 | 개요 편집·게이트 2 |
| 초안 | 승인된 개요, 리서치, 톤 가이드 | 섹션별 초안 | 사람 검토 |
| 검증 | 초안, 출처·기준 파일 | 확인 대상 목록(본문은 고치지 않음) | 사람 판단 |
| 업데이트 | 기존 URL, 성과 데이터 | 업데이트 계획 | 계획 승인 |
원문의 마지막 조언이 가장 실용적입니다. 스킬부터 만들지 말고, 콘텐츠 유형 하나로 이 워크플로를 손으로 먼저 돌려 보라는 것입니다. 몇 번 돌려 보면 어떤 지시가 반복되는지, 어디서 자주 틀리는지가 보이고, 그때 스킬로 옮깁니다. 아래 두 가지는 바로 복사해 쓸 수 있습니다. 첫 번째는 기준 파일 뼈대, 두 번째는 스킬 하나를 정의하는 양식입니다.
[콘텐츠 기준 파일 · brand-standards.md]

1. 회사·서비스 표기
- 정식 명칭 / 줄임말 허용 여부 / 영문 표기
- 지금 파는 서비스와 가격 기준일: YYYY-MM-DD

2. 더 이상 쓰지 않는 것
- 예전 서비스명·기능명 → 현재 이름
- 끝난 프로모션, 바뀐 가격, 철수한 채널

3. 톤과 문장
- 독자: (예: 중견기업 마케팅 팀장)
- 쓰는 말 / 쓰지 않는 말 (자기 평가 표현, 과장 표현 금지)
- 수치는 출처(기관·기간·대상)와 함께만 쓴다

4. 구조
- 브리프 템플릿 위치, 글 유형별 기본 구조
- 사이트맵 위치, 내부 링크로 연결할 대표 글 목록
- CTA 문구와 연결 페이지

5. 승인
- 게이트 1 승인자: (이름)
- 게이트 2 승인자: (이름)
- 발행 최종 확인자: (이름)
[Agent 스킬 정의 양식 · 단계당 하나]

이름: (예: content-verify)
언제 쓰나: (예: 초안이 완성되고 발행 전 검증이 필요할 때)
입력: (예: 초안 파일, 출처 목록, brand-standards.md, 사이트맵)
지시:
1. 초안의 수치·인용·주장을 모두 찾아 목록으로 만든다
2. 각 항목에 원본 출처 위치를 붙이고, 출처가 없으면 '출처 없음'으로 표시한다
3. 내부 링크를 사이트맵과 대조해 없는 주소를 표시한다
4. brand-standards.md의 '더 이상 쓰지 않는 것'과 겹치는 표현을 표시한다
5. 본문은 고치지 않는다. 판단은 사람이 한다
출력: 확인 대상 표(항목 / 초안 위치 / 원본 위치 / 상태)
멈춤: 출력 후 사람의 검토를 기다린다
AI가 대신할 수 없는 것은 무엇인가?
원문은 네 가지를 꼽습니다. 동료 앞에서 지킬 수 있는 독창적인 의견, 실제 프로젝트에서 직접 겪은 경험, 독자에게 무엇이 가장 중요한지에 대한 판단, 뉴스로 갑자기 부풀거나 일시적으로 왜곡된 검색 데이터를 알아보는 눈입니다. 워크플로의 두 게이트와 검증 단계는 결국 이 네 가지를 사람이 넣을 자리를 만드는 장치입니다.
PART 2·3
『AI AGENT를 지휘하는 마케터』 Part 2는 AI 결과물을 승인·조건부 승인·반려·보류 중 하나로, 사유와 함께 남기라고 권합니다. Part 3은 업무를 Draft, AI Reviewed, Human Review, Approved, Published 같은 상태값으로 관리하라고 합니다. 두 번의 승인 게이트와 검증 단계도 같은 원리입니다. 글이 지금 어느 상태이고 누가 어디까지 확인했는지가 남아야 팀이 믿고 발행합니다.
TROE는 AI 콘텐츠 워크플로를 어떻게 함께 만드는가?
콘텐츠 유형 하나로 시작해, 손으로 돌리고, 스킬로 옮기고, 성과로 다듬는 순서로 함께합니다. 기준 파일과 승인 구조를 먼저 세우고, AI 검색 노출 구조와 성과 측정까지 연결합니다.
빨리 쓰는 AI가 아니라, 발행할 수 있게 쓰는 팀의 구조를 만듭니다
2004년부터 브랜드·콘텐츠·디지털 전략 자문. 브랜드 기준과 톤 가이드, 콘텐츠 유형별 구조, 검색 성과 진단
콘텐츠 업무에 사람 승인 지점(H)과 개선 구간(P)을 표시하고, 리서치·브리프·검증 스킬을 같이 만들어 팀에 이관
AI 검색·답변에서 인용되는 콘텐츠 구조와 측정. 구글·네이버 검색 데이터를 업데이트 진단에 연결
원문은 Semrush의 How to use AI for content creation (step-by-step workflow)(Carlos Silva, 2026.11.17)입니다. 원문은 Semrush 도구와 Claude를 예로 들지만, 이 글에서는 특정 도구에 기대지 않는 국내 마케팅 팀의 운영 방식으로 다시 정리했습니다. 도구별 설정 방법은 원문에서 확인하세요.
근거와 출처
- How to use AI for content creation (step-by-step workflow) — Semrush, 2026. 이 글의 기반 원문(Carlos Silva, 2026.11.17). 준비 3가지, 7단계 워크플로와 승인 게이트 2개(합계 40~50분, 저자 경험치), 검증 항목, 업데이트 절차, 5가지 스킬, 흔한 실패 4가지
- Google Search's guidance on using generative AI content on your website — Google Search Central, 2026. 생성형 AI는 리서치와 구조화에 유용하지만, 가치를 더하지 않는 페이지를 대량으로 만들면 대규모 콘텐츠 악용 스팸 정책 위반 가능
- Google Search's guidance about AI-generated content — Google Search Central Blog, 2023. 순위 조작이 주목적인 자동 생성은 스팸 정책 위반. 콘텐츠를 누가·어떻게·왜 만들었는지(Who, How, Why) 관점
- 책 소개 2 | R-G-C-T-O-R로 설계하는 AI 마케팅 업무 지시서 — 『AI AGENT를 지휘하는 마케터』 도서 블로그, 2026. 업무 지시서 6요소로 범위·근거·검수 기준 정하기
- AX WORKS 방법론과 3분 진단 — TROE, 2026. 판단·설계·실행 3단계, H(사람 필수)·P(개선 대상) 표시
자주 묻는 질문
AI로 쓴 블로그 글은 구글 검색에서 불리한가요?
AI로 만들었다는 이유만으로 불리하지는 않습니다. 구글은 콘텐츠의 품질과 목적을 봅니다. 다만 생성형 AI로 사용자에게 가치를 더하지 않는 페이지를 대량으로 만들면 대규모 콘텐츠 악용 스팸 정책에 해당할 수 있으므로, 사람의 경험과 판단, 검증을 더하는 것이 중요합니다.
승인 게이트는 몇 번 두는 것이 좋은가요?
최소 두 번입니다. 리서치가 끝난 뒤 근거와 방향을 확인하는 게이트, 개요를 편집한 뒤 논지·범위·순서를 확인하는 게이트입니다. 몇 번 잘 돌아갔다고 게이트를 없애면, 잘못된 경쟁사나 검색 의도 위에 글 전체가 쓰일 수 있습니다.
AI가 쓴 초안의 사실 확인도 AI에게 맡기면 안 되나요?
확인할 대상을 표시하는 일은 AI에게 맡길 수 있지만, 맞는지 판단하는 일은 사람이 원본을 열어 해야 합니다. 원문 저자도 AI가 맞는 내용을 틀렸다고 표시한 사례를 들며, 모델이 자기 주장을 스스로 판단하게 두지 말라고 권합니다.
이 워크플로를 SNS 게시물, 영상 대본, 이메일에도 쓸 수 있나요?
쓸 수 있습니다. 준비 단계와 두 번의 검토는 그대로 두고, 형식별 지시만 바꿉니다. SNS는 플랫폼·후킹·CTA, 영상은 길이와 말하기 구조, 이메일은 대상·오퍼·준수 사항을 지시서에 넣습니다.
어떤 AI 도구를 써야 하나요?
특정 도구보다 조건이 중요합니다. 기준 파일을 계속 참고하게 둘 수 있고, 검색·분석 데이터에 연결할 수 있고, 반복 지시를 저장해 재사용할 수 있는 도구를 고릅니다. 원문 저자는 Claude를 쓰고, ChatGPT로도 비슷한 구성이 가능하다고 설명합니다.
TROE는 AI 콘텐츠 워크플로 구축을 어떻게 돕나요?
팀의 콘텐츠 유형 하나를 골라 기준 파일과 브리프 템플릿, 승인 게이트, 검증 체크리스트를 함께 만들고, 손으로 몇 번 돌려 본 뒤 반복 단계를 Agent 스킬로 옮깁니다. AI 검색 노출 구조와 성과 측정까지 함께 설계합니다.